4.4 Drylab中的单细胞RNA测序(scRNA-seq)工作流程
开始使用

GSE162631(胶质母细胞瘤单细胞 RNA 测序,scRNA-seq)的完整操作流程——从原始 10x 计数到已注释的细胞群(clusters)——并附带每一步所使用的确切提示词(prompts)。
第一阶段:准备工作
在运行任何程序之前,先找到合适的工作流并进行妥善的简报。
1. 寻找工作流:搜索 @scrna
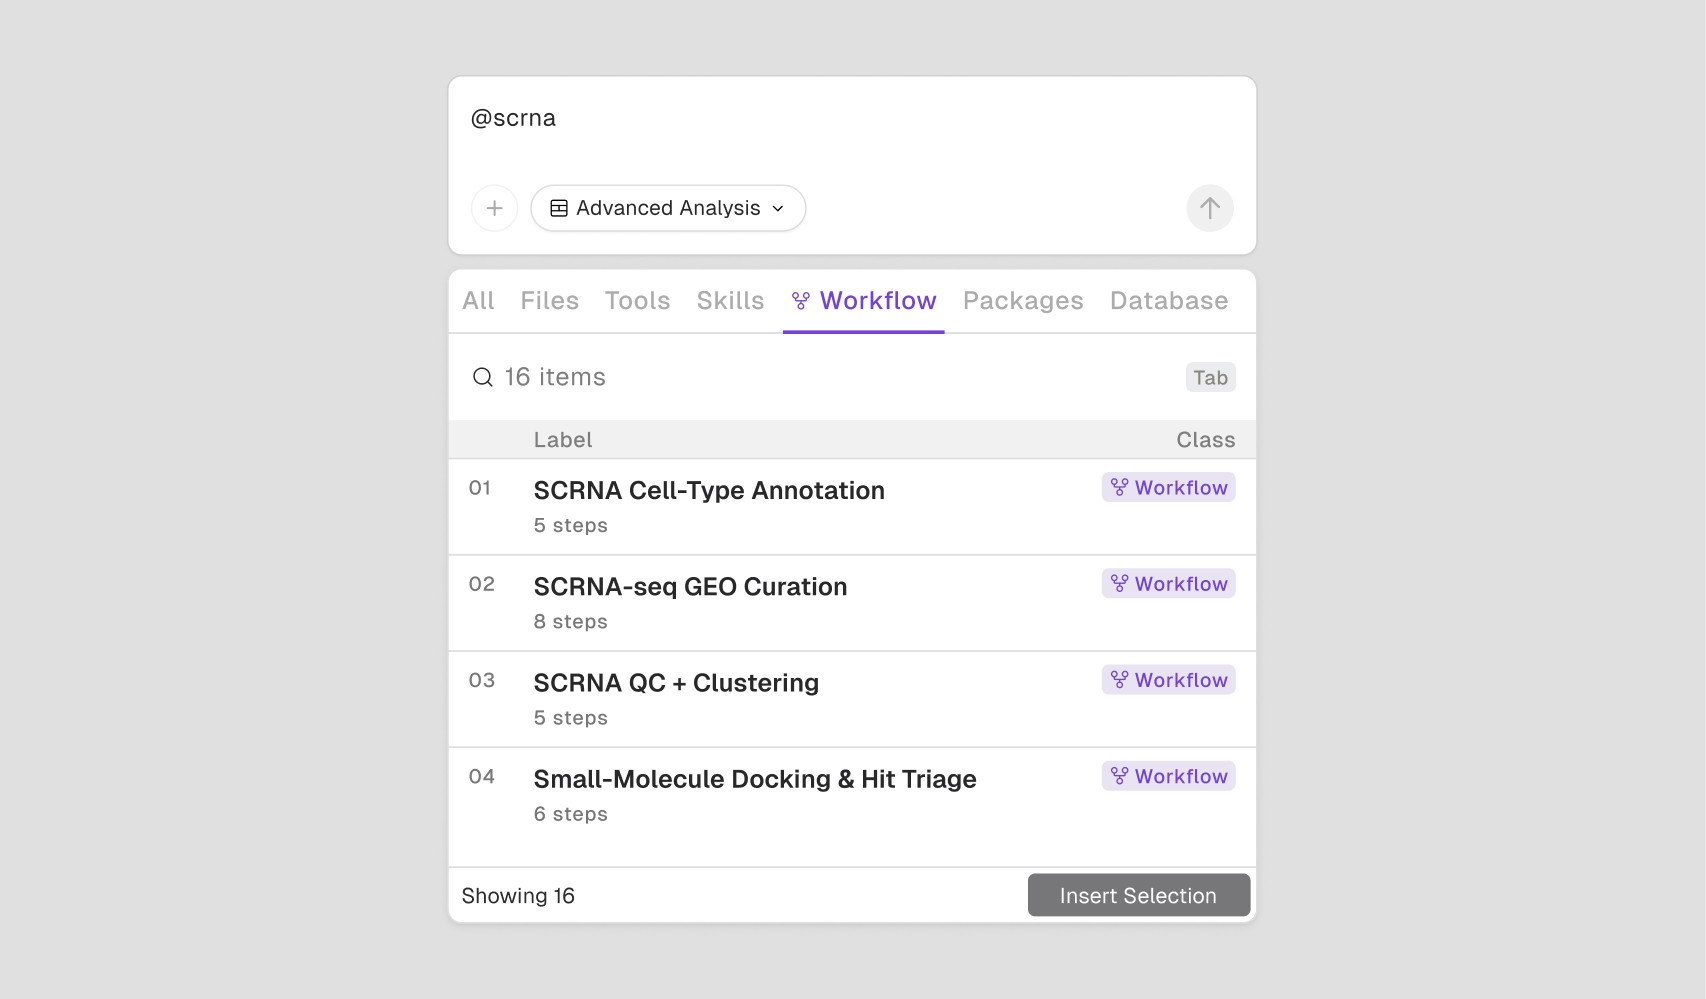
在新对话中输入 @scrna。Drylab 将筛选出四个单细胞工作流:scRNA Cell-Type Annotation(单细胞 RNA 细胞类型注释)、scRNA-seq GEO Curation(单细胞 RNA 测序 GEO 数据整理)、scRNA QC + Clustering(单细胞 RNA 质控与聚类)、Spatial Domain Detection & Annotation(空间域检测与注释)。本指南将首先使用 scRNA QC + Clustering,随后再链接到 scRNA Cell-Type Annotation 工作流。
2. 预览工作流:阅读带编号的步骤及其标签
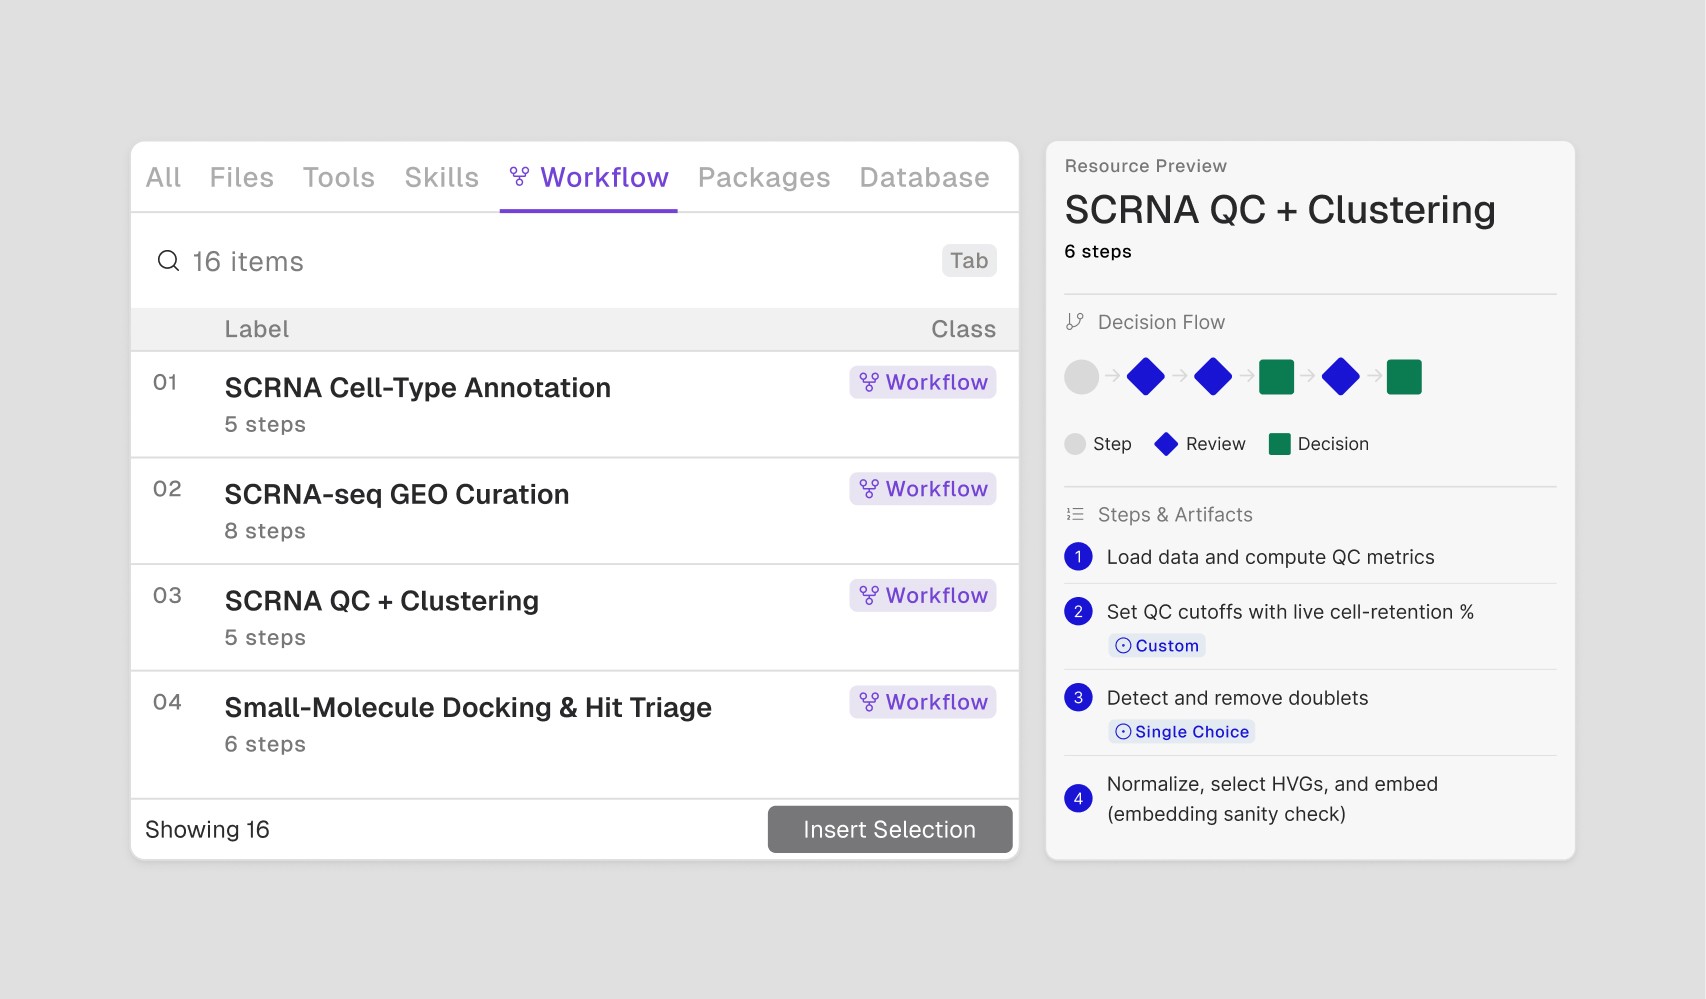
在选择之前,先滚动浏览资源预览。scRNA QC + Clustering 包含六个步骤:(1) 加载数据并计算质控(QC)指标,(2) 设置质控阈值(自定义),(3) 检测并去除双细胞(Single Choice,单选),(4) 归一化、选择高变基因(HVG)并进行降维嵌入(Gating Tree,门控树),(5) 选择聚类分辨率(Image Choice,图片选择),(6) 导出经质控和聚类处理的对象。这六个步骤中有三个会暂停以等待您的输入,标签会提示您是哪几个步骤以及如何交互。
3. 阅读文档和所使用的技能
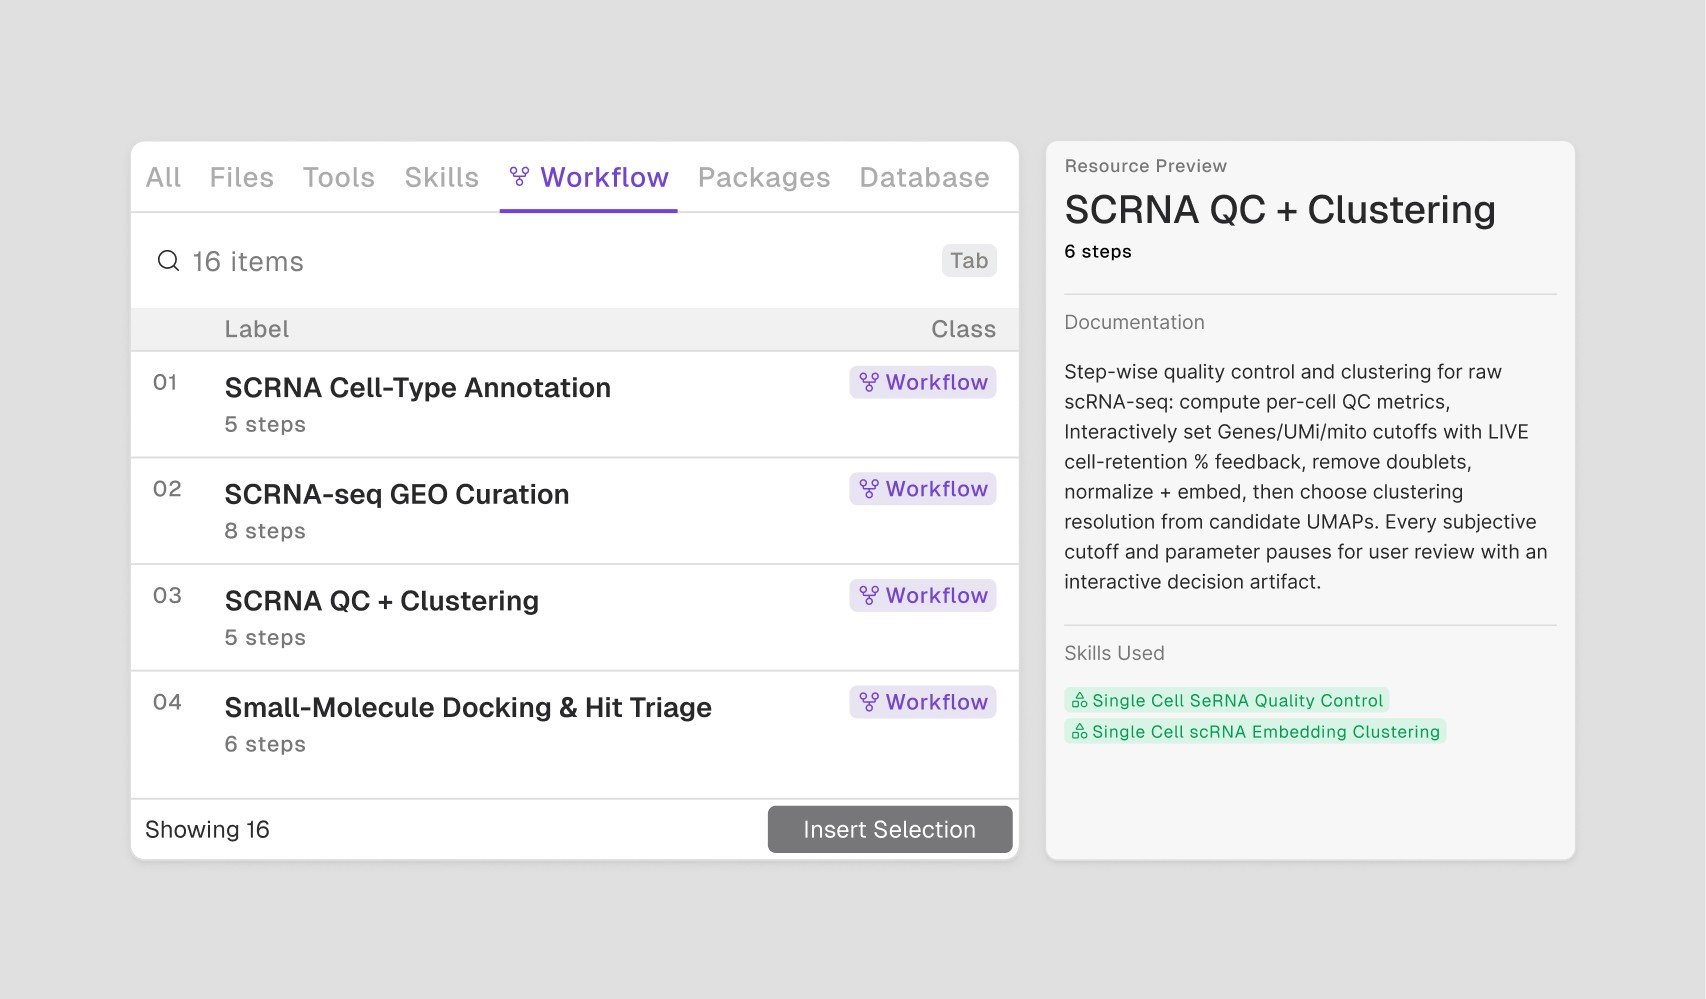
文档确认了这是正确的工作流:“针对原始 scRNA-seq 数据进行逐步质控和聚类:计算每个细胞的质控指标,通过实时细胞保留率(%)反馈交互式设置 nGenes/UMI/线粒体基因(mito)截断值,去除双细胞,进行归一化和降维嵌入,然后从备选的 UMAP 图中选择聚类分辨率。”所使用的技能(Skills Used)列出了 Single Cell scRNA Quality Control(单细胞 RNA 质控)和 Single Cell scRNA Embedding Clustering(单细胞 RNA 降维嵌入与聚类)。
4. 设置您的审核模式
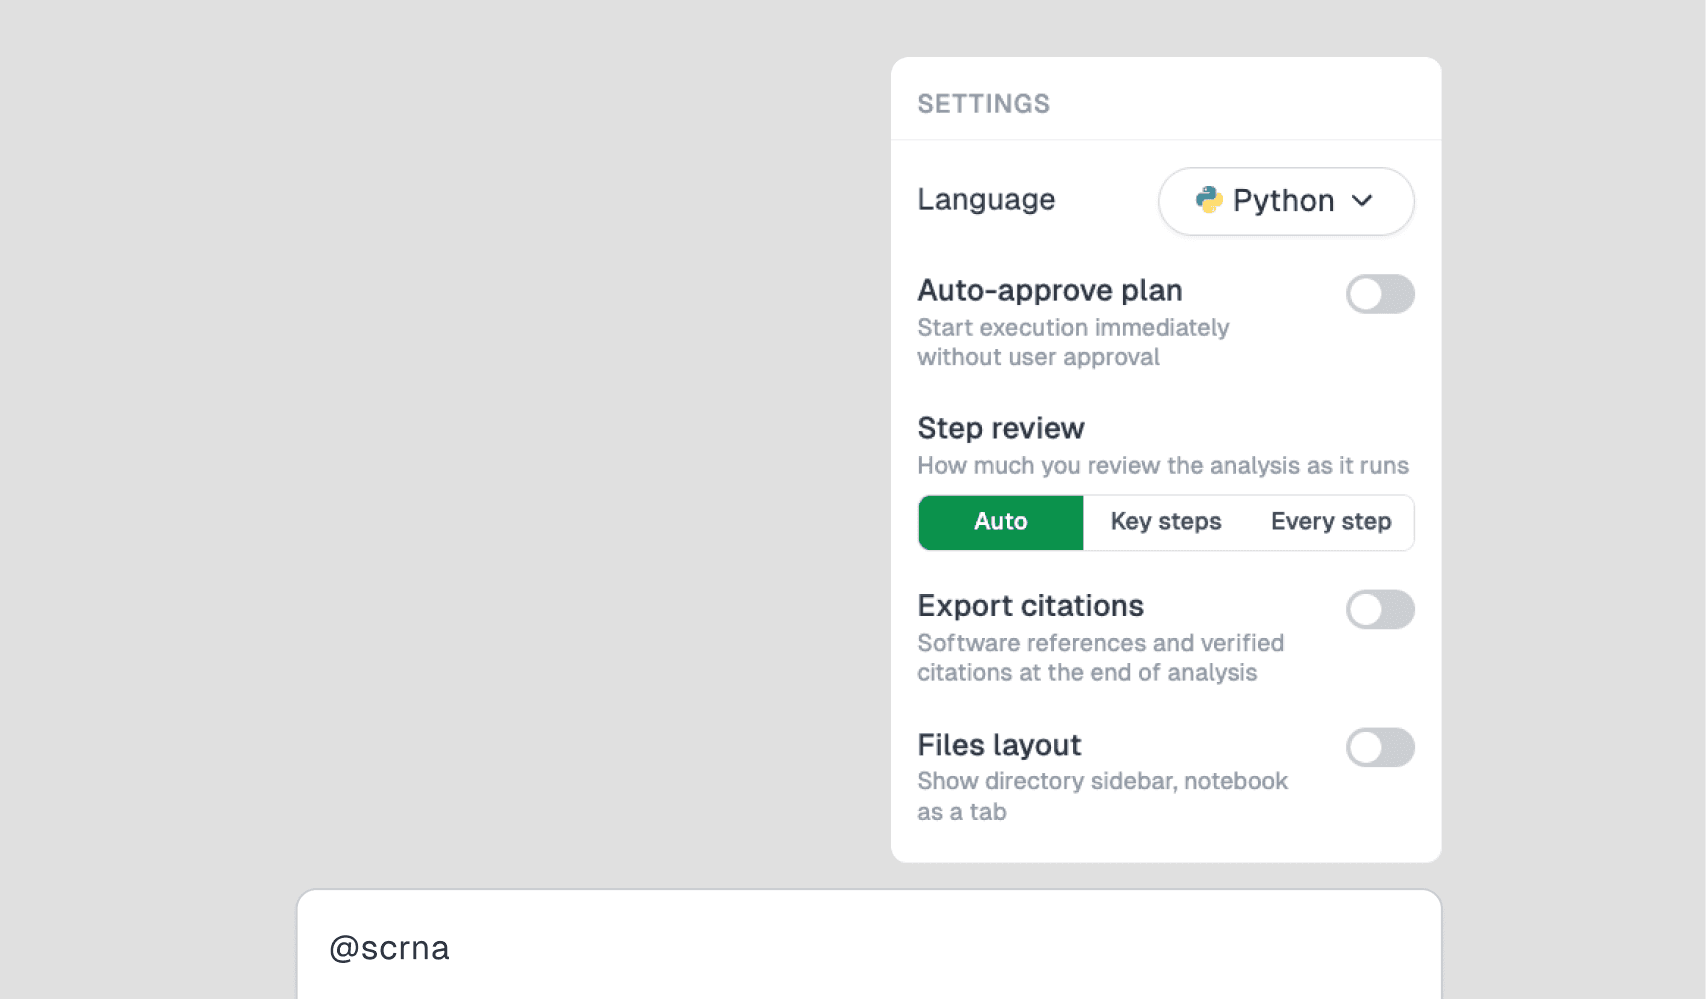
如果您是首次在该数据集上运行质控(QC)和聚类(Clustering),请将步骤审核(Step review)设置为 Every step(每一步),这样您就能看到发生的每一个检查点。在验证过阈值并重新运行程序时,您可以将其放宽至 Auto(自动)。
第二阶段:质控与聚类
启动任务,然后随着 Drylab 呈现各个检查点,逐一完成。
1. 使用设定了完整参数的提示词启动任务
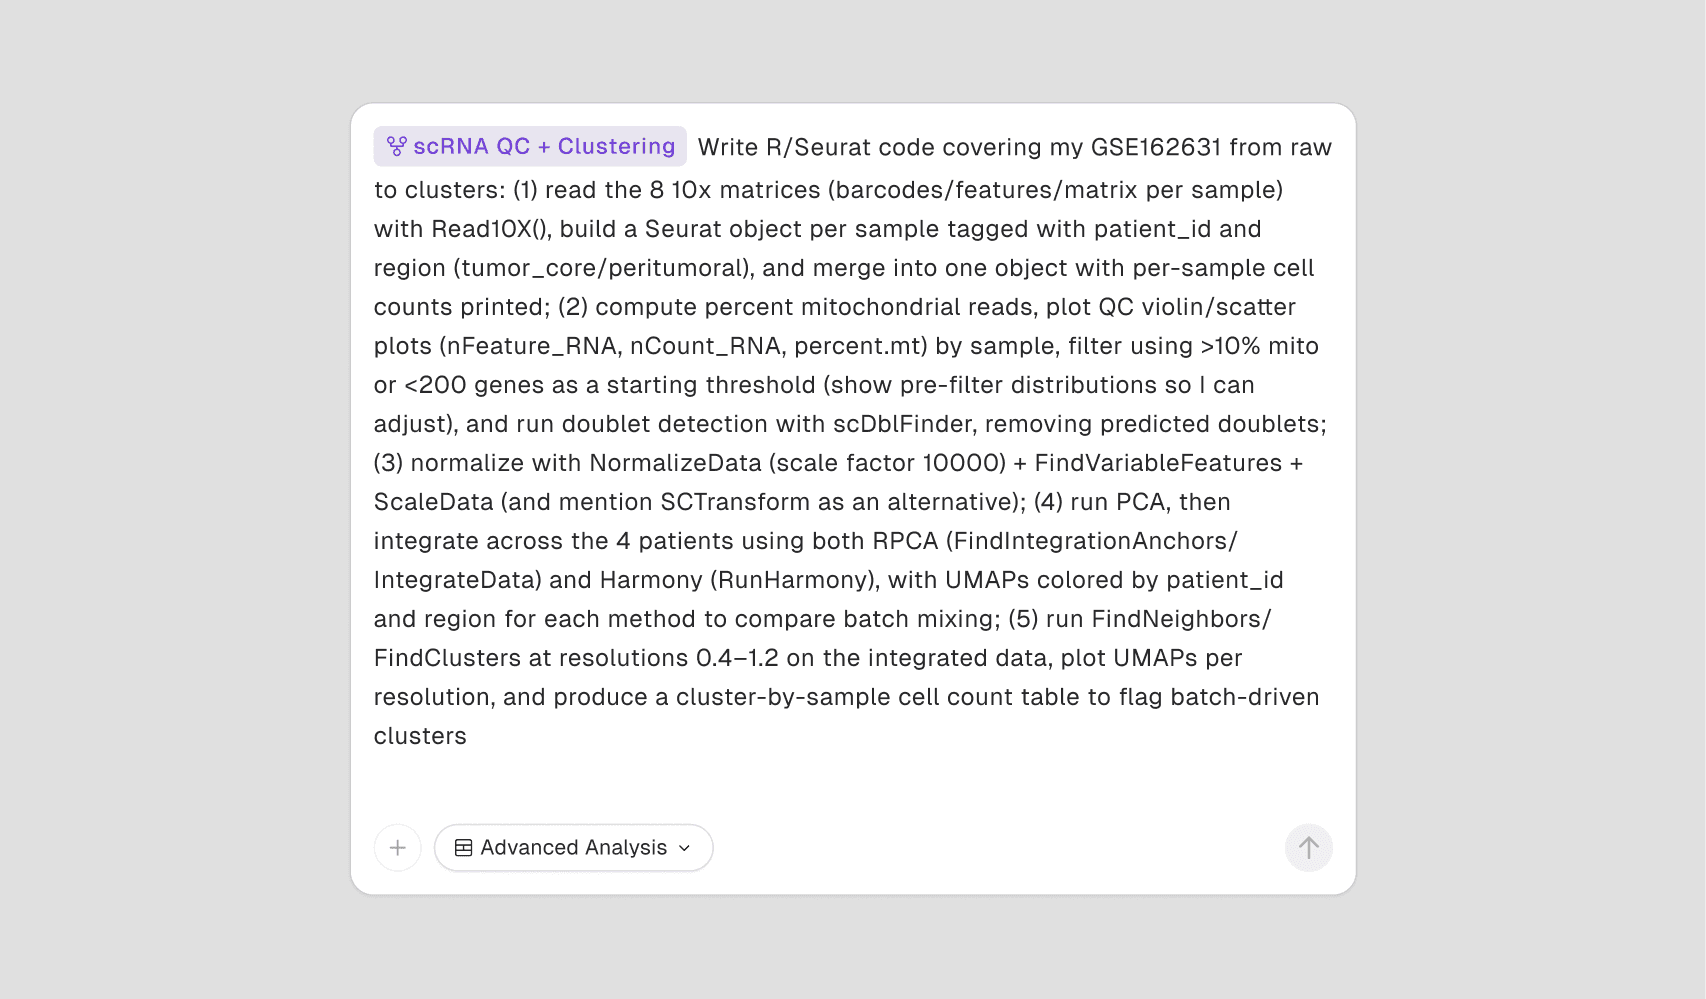
这是用于启动本指南操作的实际提示词——使用了 @scRNA QC + Clustering,随后紧跟 Drylab 所需的所有详细参数:
请注意,它指明了每一个工具(Read10X、scDblFinder、NormalizeData、RPCA、Harmony)、每一个阈值(线粒体占比 >10%、基因数 <200、分辨率 0.4–1.2)以及每一个元数据字段(patient_id、region)——没有留下任何让 Drylab 凭空猜测的空间。
2. 审核生成的运行计划
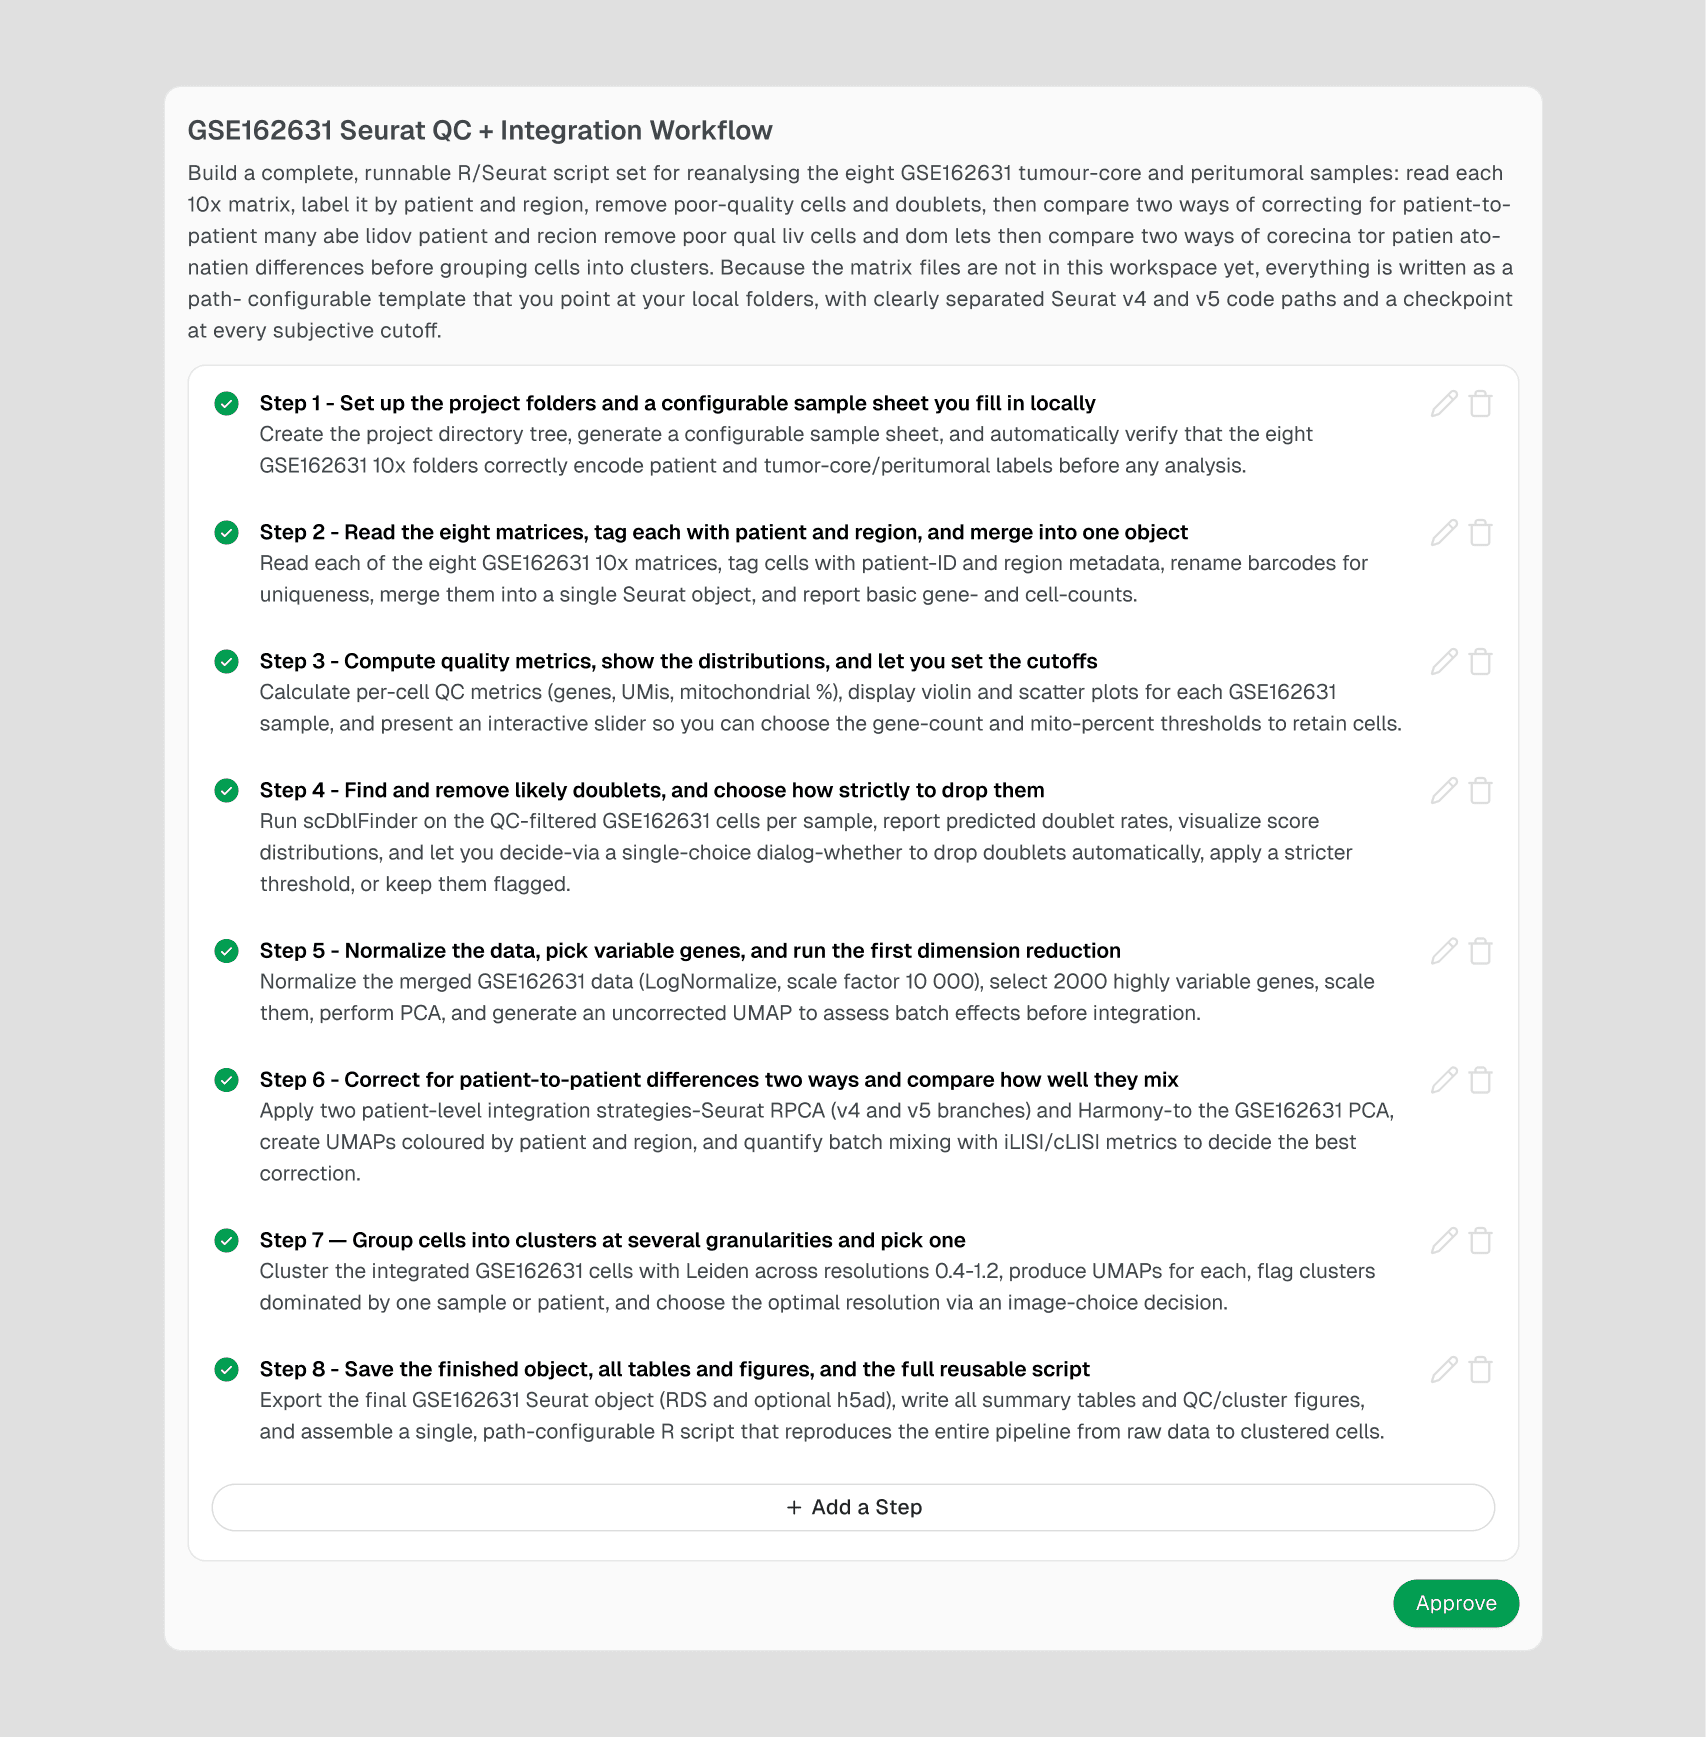
Drylab 将提示词转化为七个具名的步骤——从“读取所有八个样本、标记患者和区域并检查数据质量”一直到“保存完成聚类的数据集、代码和总结表”。请仔细阅读每一步,如果发现问题,在运行计算之前,您可以在此编辑或删除步骤。
3. 批准——或接受推荐配置并批准
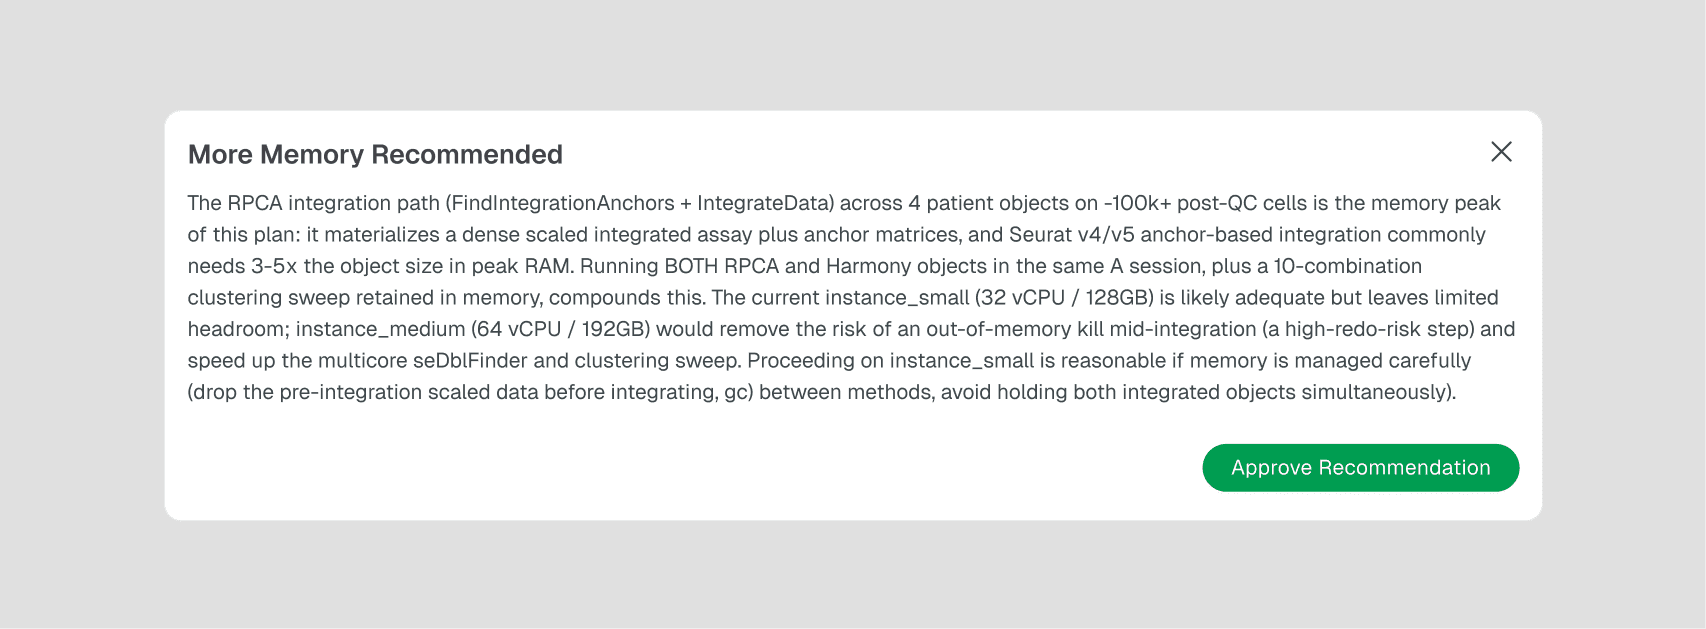
滚动到计划的底部,在您批准之前,Drylab 可能会提示资源方面的顾虑——此处提示“建议增加内存”,因为在同一个会话中同时运行 RPCA 和 Harmony 整合分析是非常消耗内存的。“Approve Plan”(批准计划)将按指定配置运行;“Approve with [suggestion]”(接受建议并批准)则会采用升级后的实例规格。
4. 回答整合方法澄清问题
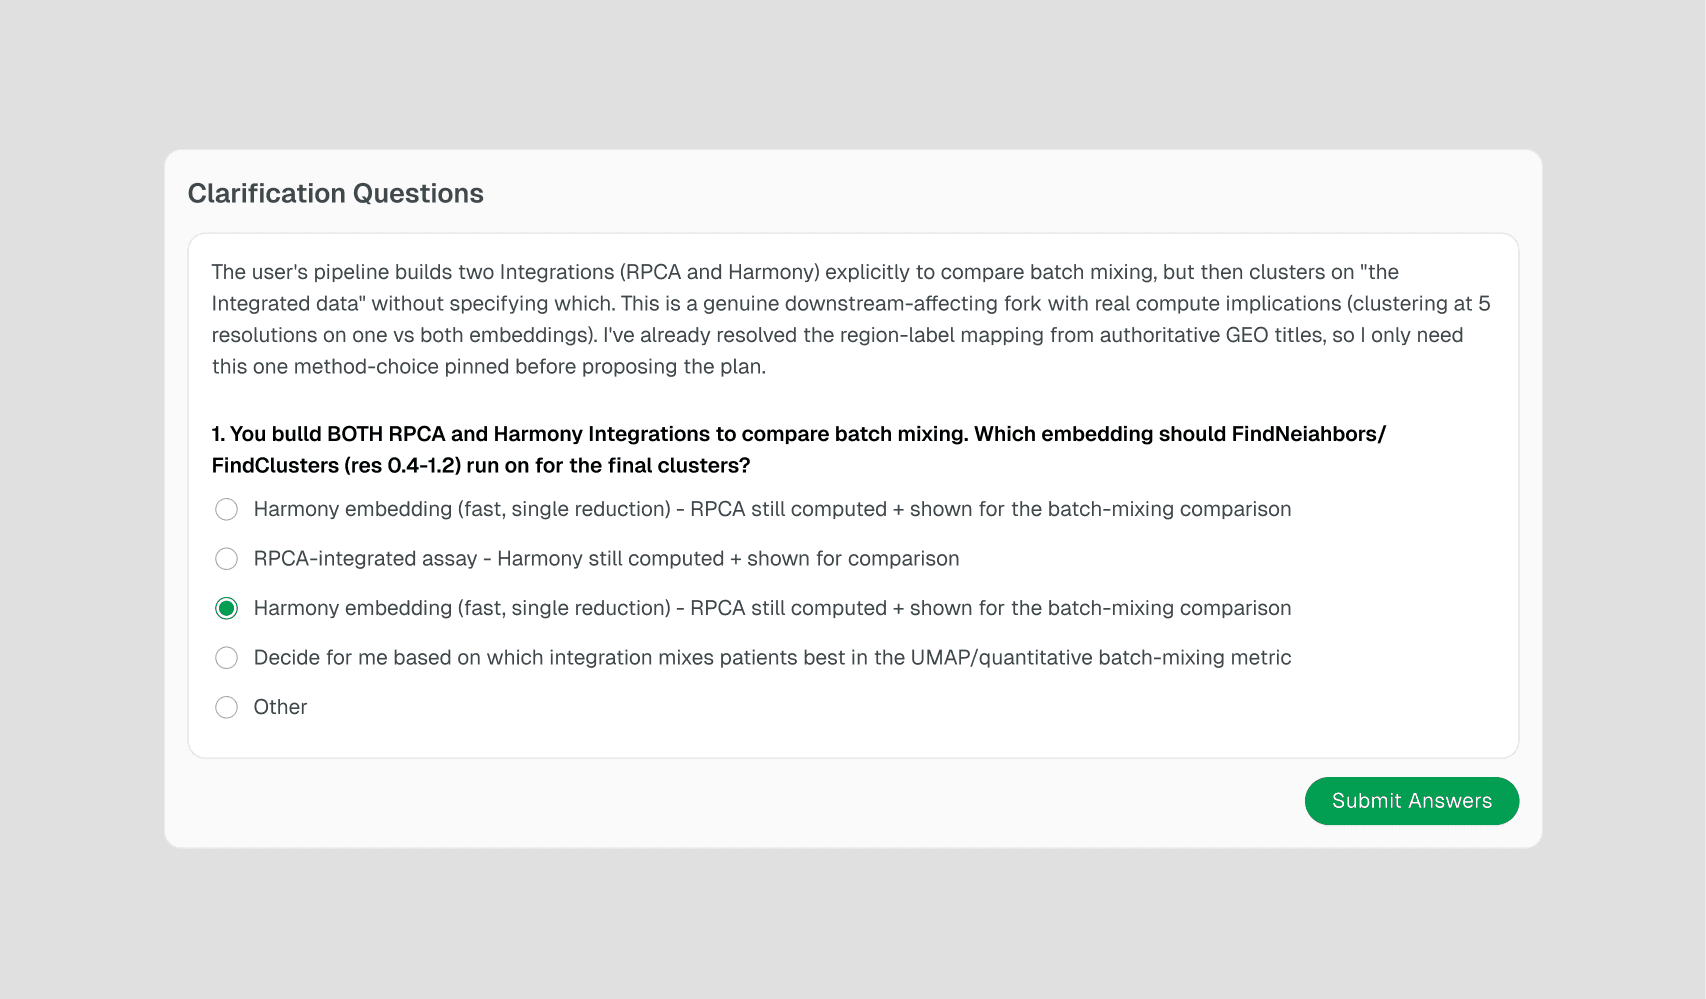
在运行中途,Drylab 遇到了一个真正的抉择点:提示词要求同时使用 RPCA 和 Harmony 来比较批次效应的混合情况,但并未说明应基于哪种方法的结果进行后续聚类。它解释了折中方案并提供了四个选项。在这里,选择了“在两者上均进行聚类,并直接提供两张‘细胞群-样本’(cluster-by-sample)对照表”——从而获得直接的对比,而不是盲目相信 Drylab 的默认推荐。
5. 利用实时证据拖动质控(QC)阈值
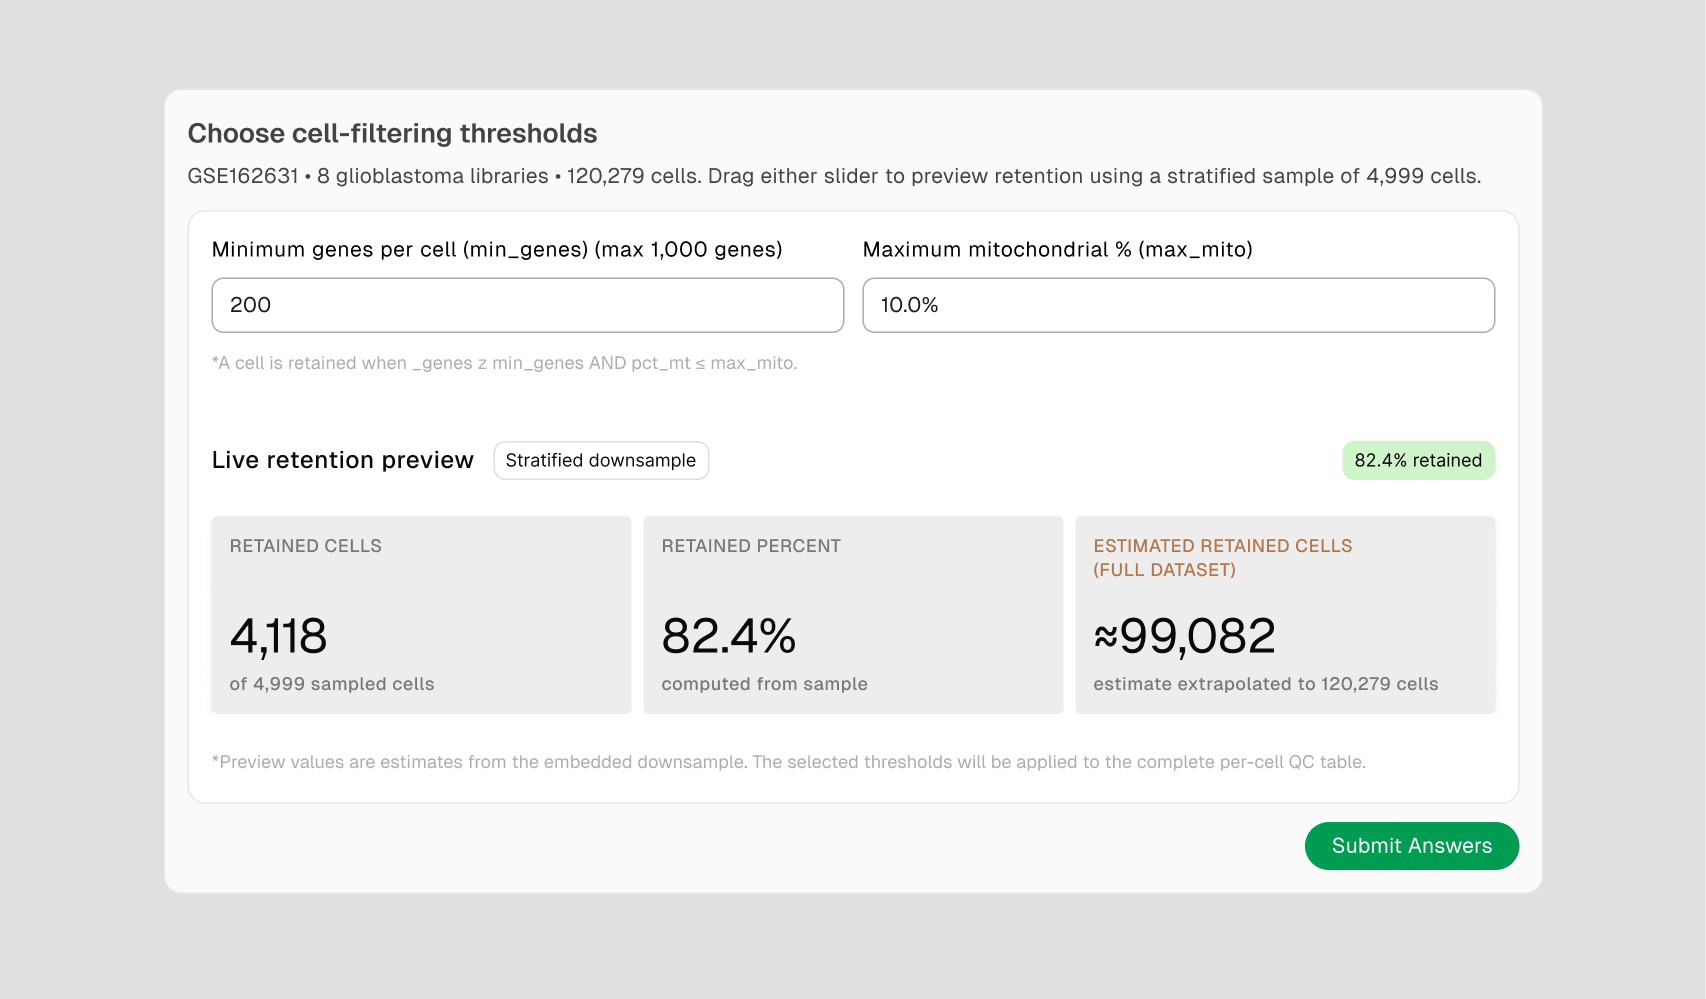
交互式质控检查点会预填您要求的默认值(200 个基因,10% 的线粒体基因),并立即显示其产生的结果:在此默认值下,在 4,999 个细胞的分层抽样中保留了 82.4%,推算到全部 120,279 个细胞中大约保留 99,082 个。在确认之前,可以拖动任意滑块实时查看数值的变化——无需重新运行即可获知结果。
6. 对比 RPCA 与 Harmony,并直观选择分辨率
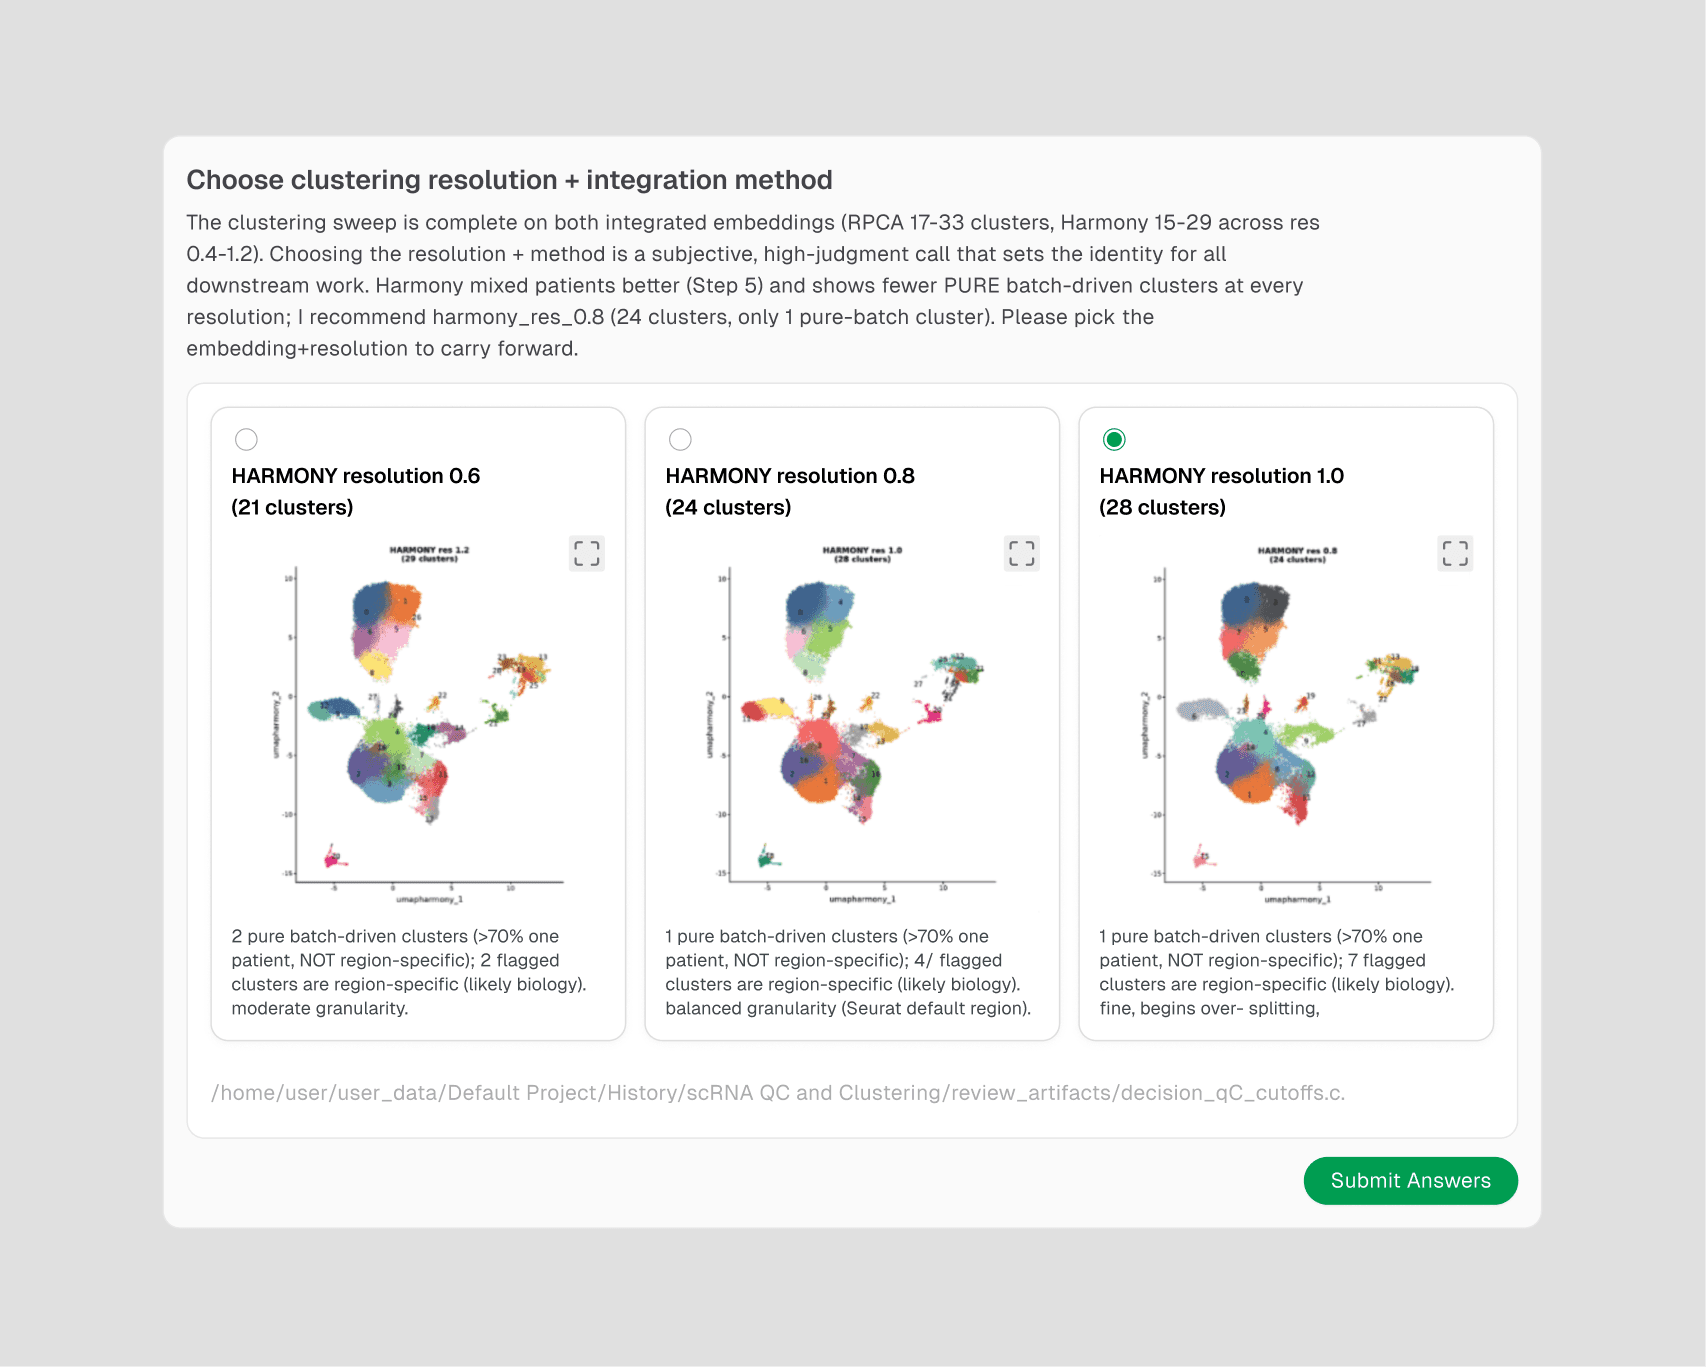
聚类参数扫描对这两种降维嵌入方法分别运行了五个分辨率(RPCA 产生 17-33 个细胞群;Harmony 产生 15-29 个细胞群)。Drylab 推荐使用 harmony_res_0.8(包含 24 个细胞群,其中仅有 1 个纯批次细胞群,是所有选项中最少的),并展示了每个备选的 UMAP 图,且在下方标明了其因批次效应导致的细胞群数量,以便您可以核实推荐结果,而非盲信。
7. 在继续下一步之前检查溯源表
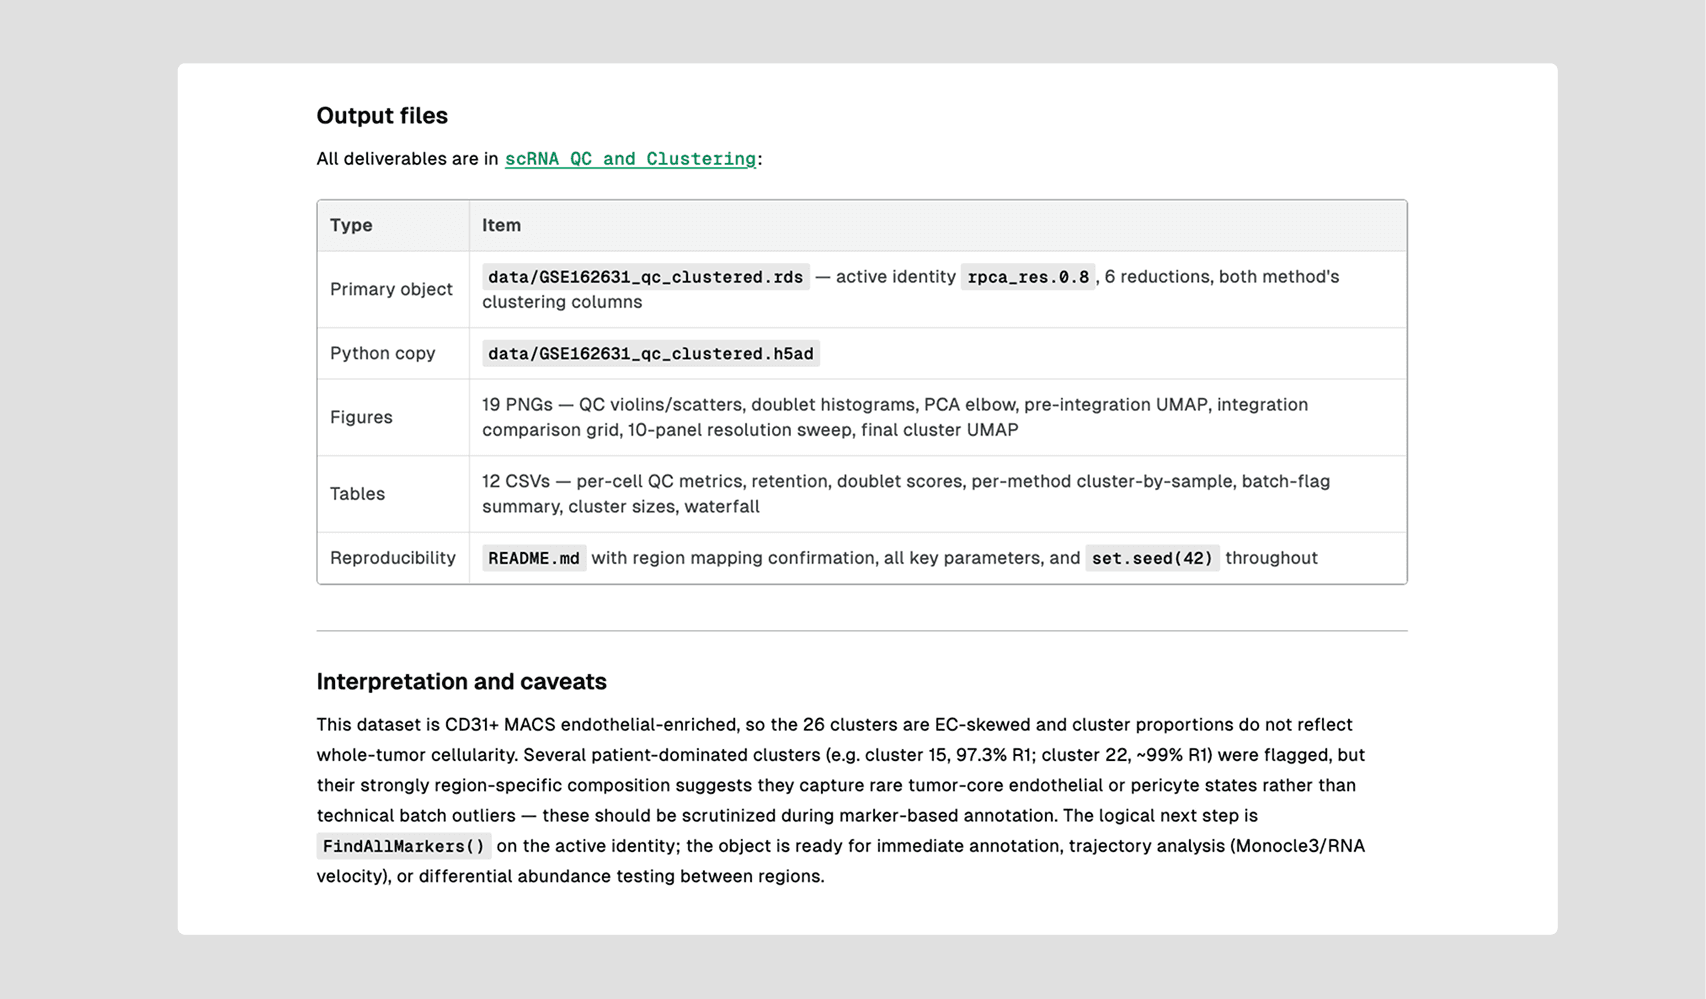
完成的步骤会精确报告所生成的产物:主 .rds 对象(活动身份为 rpca_res_0.8,保留了两种方法的聚类列)、一个可由 Python 读取的 .h5ad 副本、19 张图表、12 张表格,以及一个记录了区域映射确认信息、每个参数和全程使用 set.seed(42) 的 README 文件。这就是您要移交给合作者,或是在六个月后需要核对的文件。
第三阶段:细胞类型注释
直接链入标注流程,使用您刚刚构建的聚类对象。
1. 链入带您自定义标记物(markers)的细胞类型注释流程
在同一个对话中,标记下一个工作流,并提供经典的特征标记物(canonical markers),而不是接受通用的默认标记物——以下是实际使用的提示词:
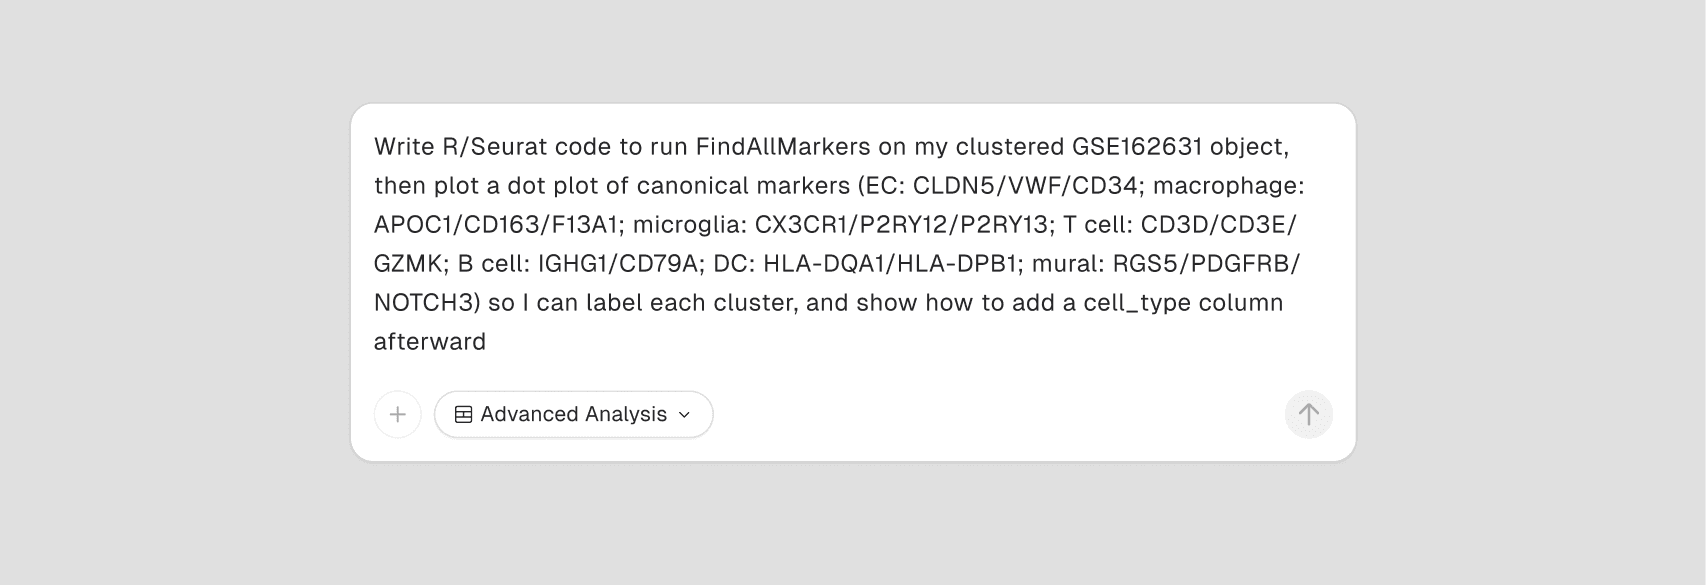
该标记物面板是专门针对这种肿瘤微环境(内皮细胞、巨噬细胞、小胶质细胞、T/B 细胞、树突状细胞、壁细胞)设计的。您可以将标记物集换成您自己组织专属的标记物——其工作流结构(FindAllMarkers → 气泡图 dot plot → 标注 label → cell_type 列)保持不变。
2. 对照标记物证据确认细胞类型标签
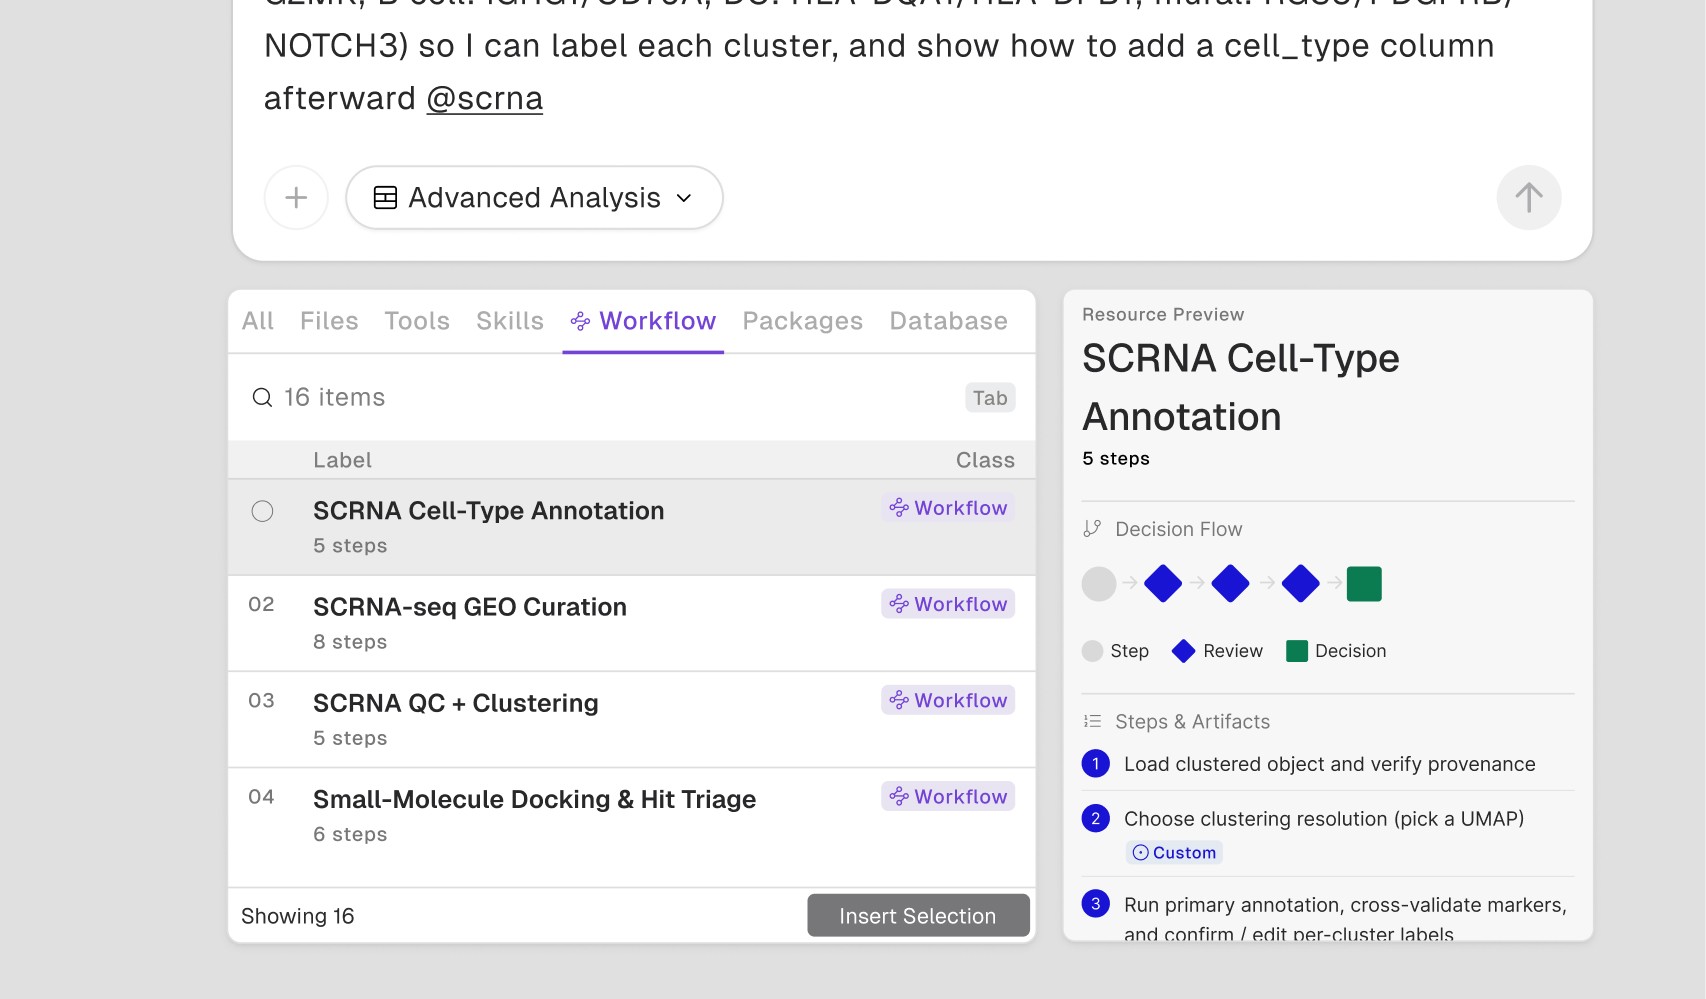
“细胞类型注释”(Cell-Type Annotation)自身的文档设定了预期目标:“从备选的 UMAP 图中选择聚类分辨率,对照标记物证据确认每个细胞群的标签,决定对哪些混合细胞群进行亚群聚类(subclustering),解决含糊/低置信度的判定,并导出带有溯源追踪的已注释对象。”步骤 3“运行初步注释”(Run primary annotation)被标记为 Table Edit(表格编辑)——您将看到针对每个细胞群生成的标签,并可以纠正任何与您的标记物面板不符的标签。
3. 决定是否对混合细胞群体进行亚群聚类
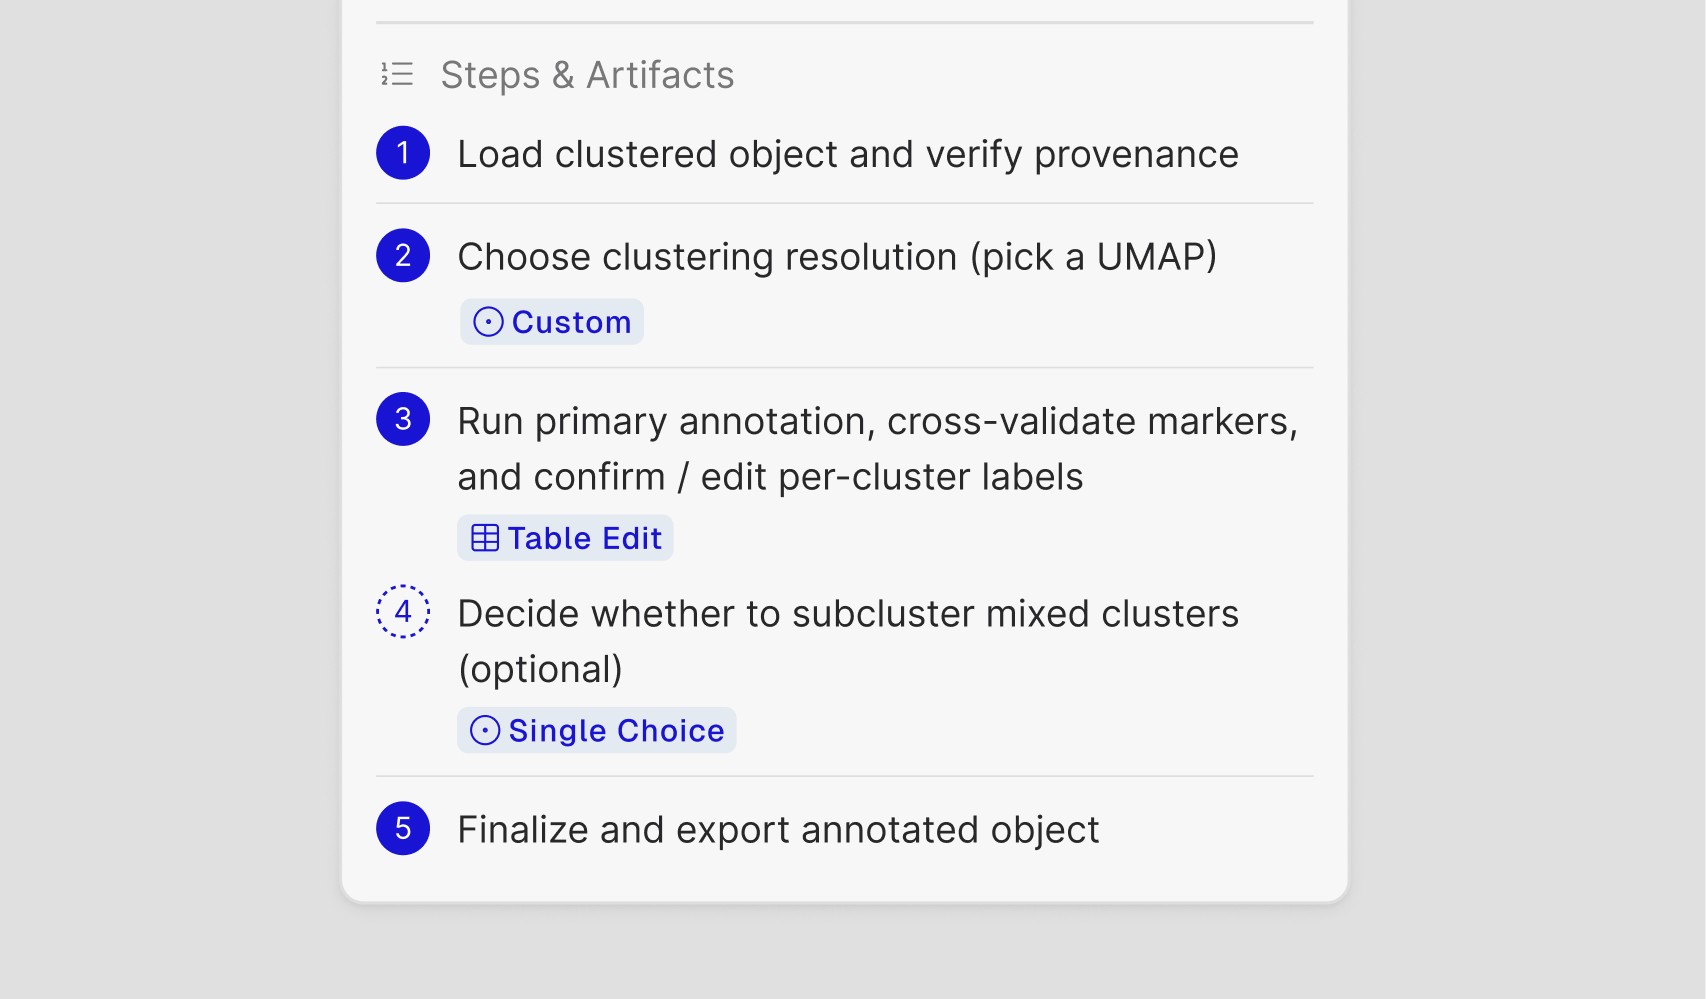
步骤 4 是明确可选的,并被标记为 Single Choice(单选):如果某个细胞群显示出混合的标记物信号(例如,同时存在巨噬细胞和小胶质细胞的标记物),您可以决定是将其进一步细分,还是将其作为一个群体接受。任何亚群聚类都不会在后台默默进行——该选项会呈现出来并等待您的决策。