本应用案例由学术研究人员与 Drylab 共同创建。完整的对话过程展示了研究人员如何与 Drylab 进行交互以执行分析、提出问题,并随着新见解的涌现而调整工作流程。
我们希望这些示例能为您自己的研究带来新的方法和启示。
摘要
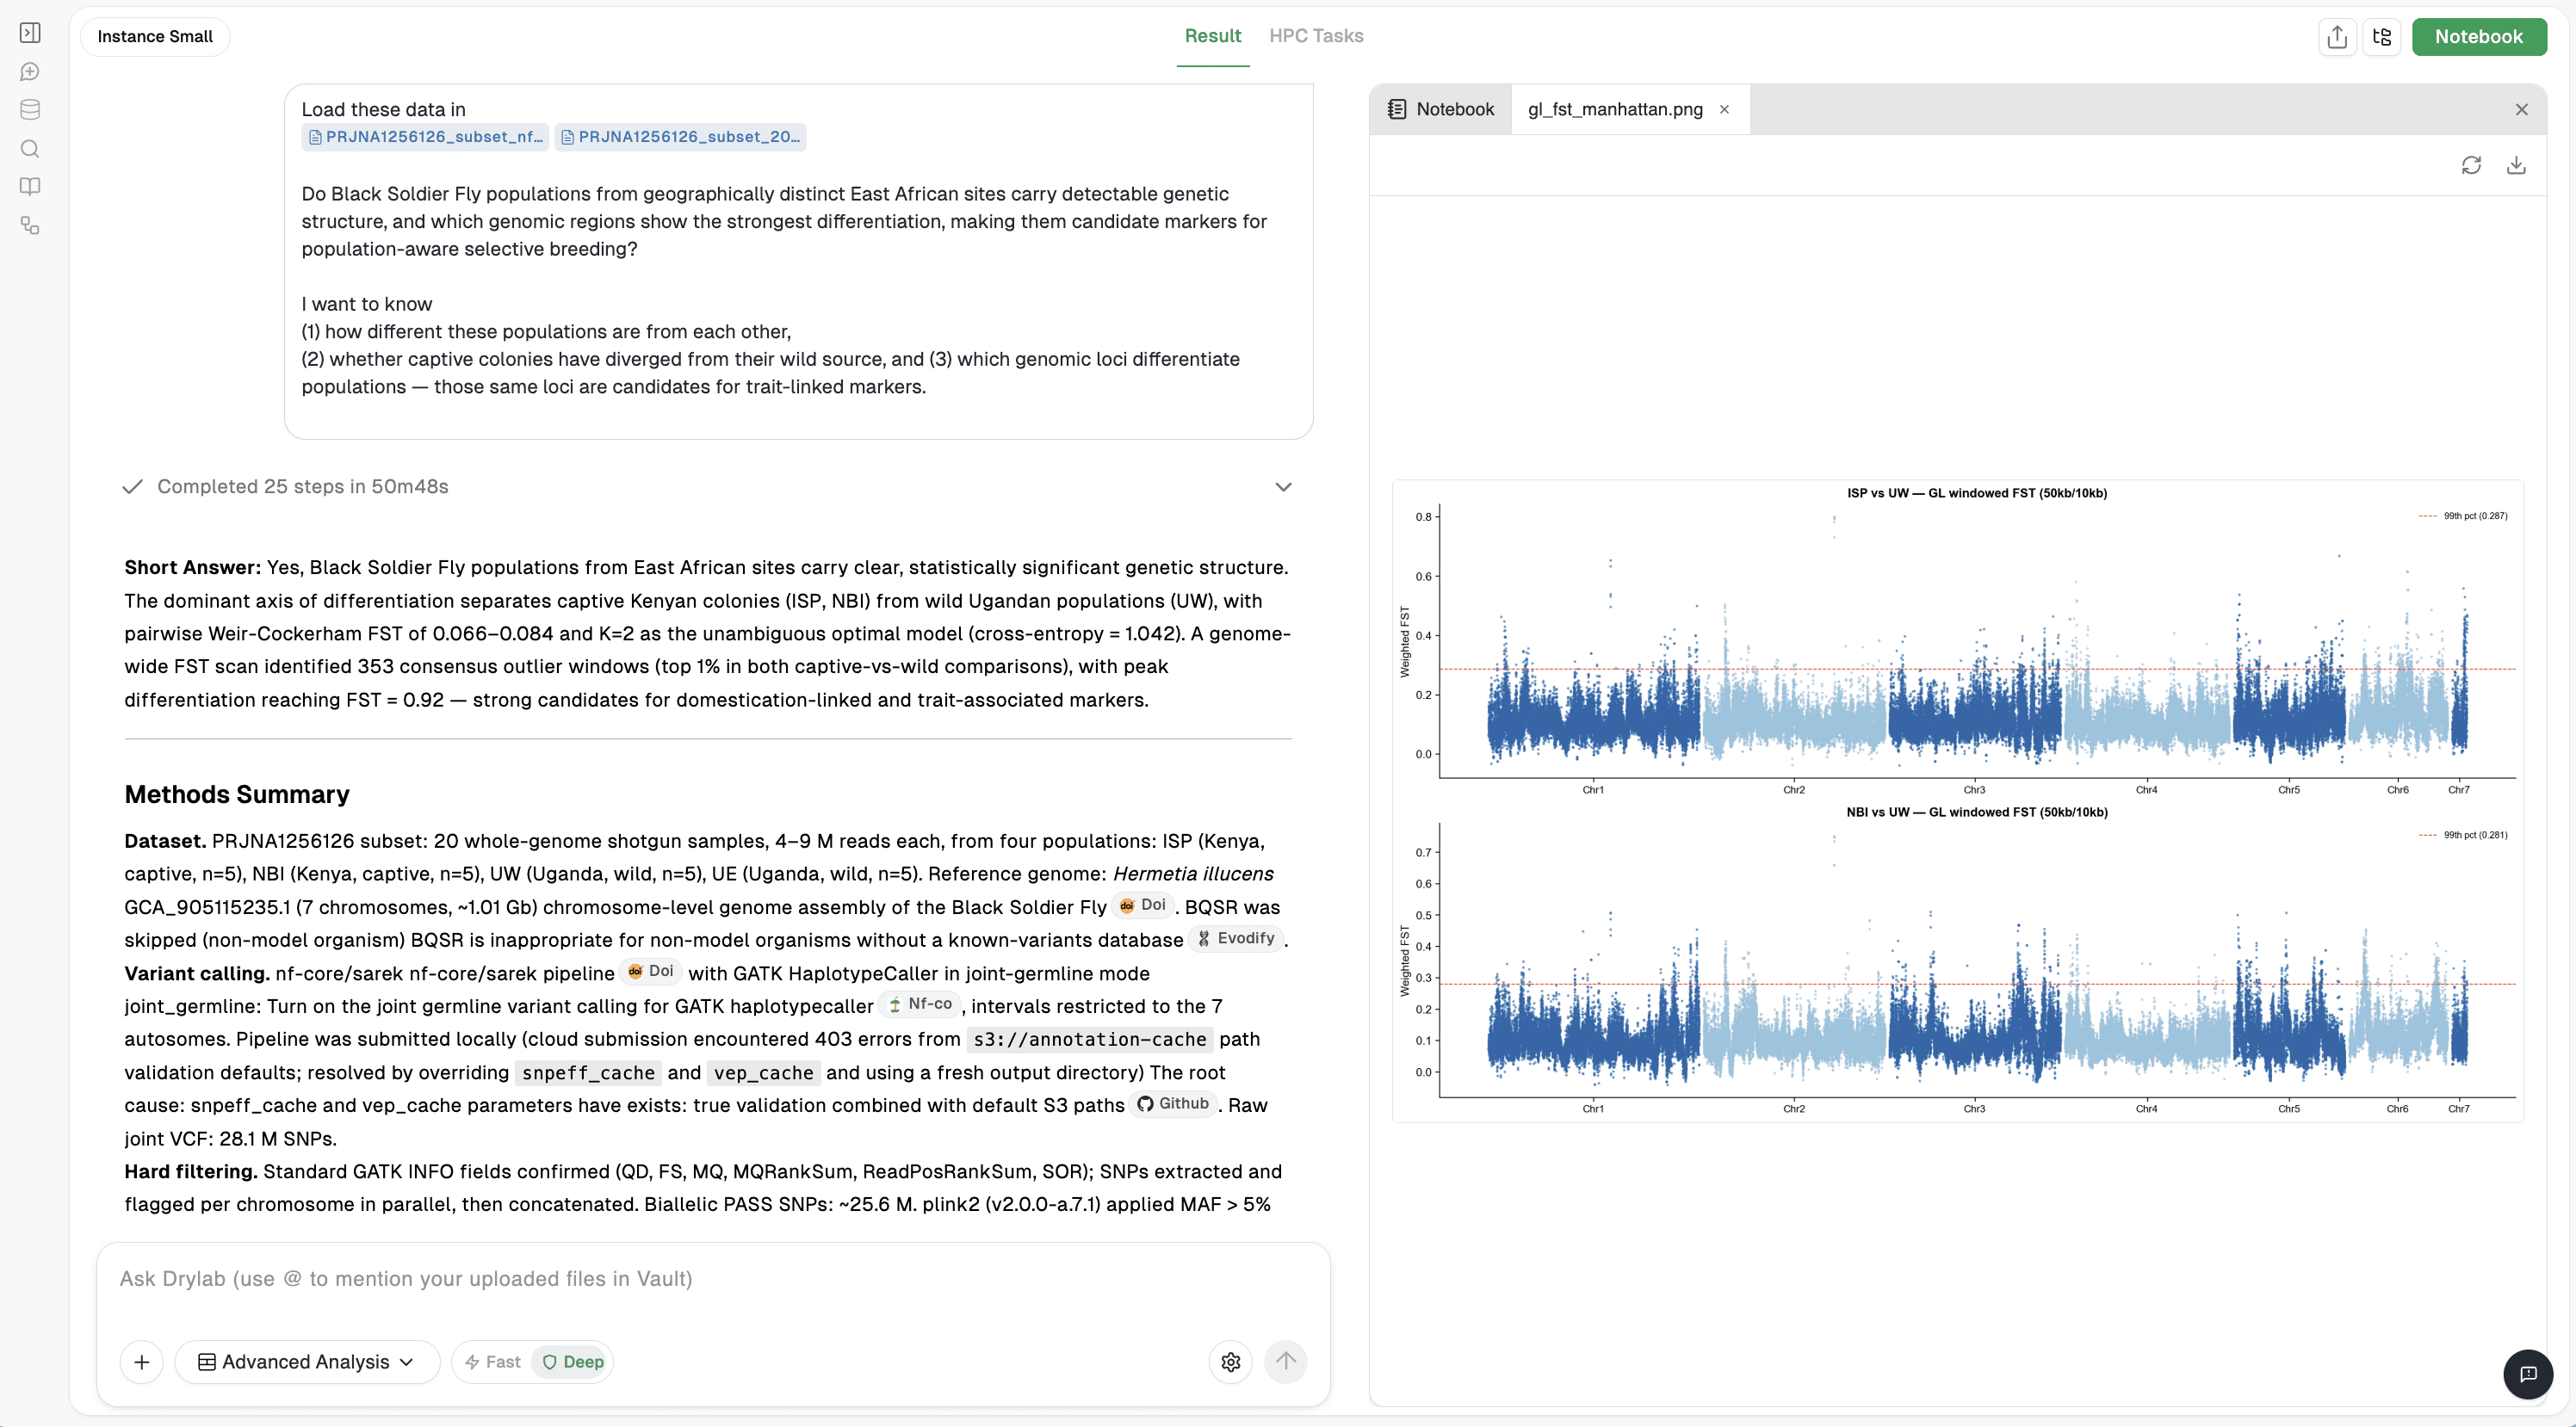
分析全基因组重测序数据,以量化群体间的遗传结构,评估饲养群体与野生群体之间的分化,并鉴定受选择的基因组区域。此工作流程有助于解答以下问题:
(1) 这些群体之间的差异有多大
(2) 哪些基因组位点分化了群体——这些位点即为性状关联标记的候选位点。
输入
全基因组重测序数据(每个样本约 1× 覆盖度)
4 个群体:
ISP(工业化饲养群体,肯尼亚)
NBI(工业化饲养群体,肯尼亚)
UW(野生群体,乌干达西部)
UE(野生群体,乌干达东部)
初步鉴定出超过 450 万个 SNP
输出
质量控制与污染检测
群体结构分析 (PCA)
群体混杂分析 (Admixture)
遗传分化度分析 (FST)
选择性扫荡检测 (Selective sweep)
传统硬呼叫 (Hard-call) 方法与基因型似然值 (GL) 方法之间的交叉验证
自动生成最终报告
关键生物学结论
1. 工业化饲养群体正逐渐与野生群体发生分化
饲养群体与野生群体的分化度达到:
ISP vs UW: FST = 0.113
NBI vs UW: FST = 0.106
2. 发现了一个主要的候选驯化位点
在以下位置检测到了最强的选择信号:
2 号染色体(约 137.35 Mb),其中:
FST = 0.801 (ISP vs UW)
FST = 0.753 (NBI vs UW)
重要的是,该信号独立出现在两个商业饲养群体中,表明在工业化育种过程中存在共同的适应性响应。
3. 鉴定出其他候选选择区域
次级候选区域:5 号染色体(约 77.9 Mb)
潜在的三级候选区域:3 号染色体(约 173.5 Mb)
这些区域可能包含与生长、饲料转化效率、环境适应性或生产性能等性状相关的基因。
分析细分说明
数据集: PRJNA1256126 子集:20 个全基因组鸟枪法测序样本,每个样本 4-9 M reads,来自四个群体:ISP(肯尼亚,饲养,n=5),NBI(肯尼亚,饲养,n=5),UW(乌干达,野生,n=5),UE(乌干达,野生,n=5)。参考基因组:黑水虻(Black Soldier Fly)染色体水平基因组组装版本 Hermetia illucens GCA_905115235.1(7 条染色体,约 1.01 Gb)。跳过 BQSR(非模式生物),因为在没有已知变异数据库的情况下,对非模式生物进行 BQSR 是不合适的。
原始数据处理
变异检测 (Variant calling):使用 nf-core/sarek 流程,采用 GATK HaplotypeCaller 联合群体检测模式 (joint-germline mode),区间限制在 7 条常染色体上。分析流程在本地提交运行。
硬过滤 (Hard filtering):确认了标准的 GATK INFO 字段(QD, FS, MQ, MQRankSum, ReadPosRankSum, SOR);并行提取并标记每条染色体上的 SNP,然后进行合并。获得双等位基因 PASS SNP 约 25.6 M。使用 plink2 (v2.0.0-a.7.1) 过滤 MAF > 5% 且 --geno 0.50(最大缺失率 50%,考虑到此下采样概念验证数据集中约 1× 的覆盖度,这是最低可行阈值);最终保留了 1,681,501 个 SNP。
样本质控
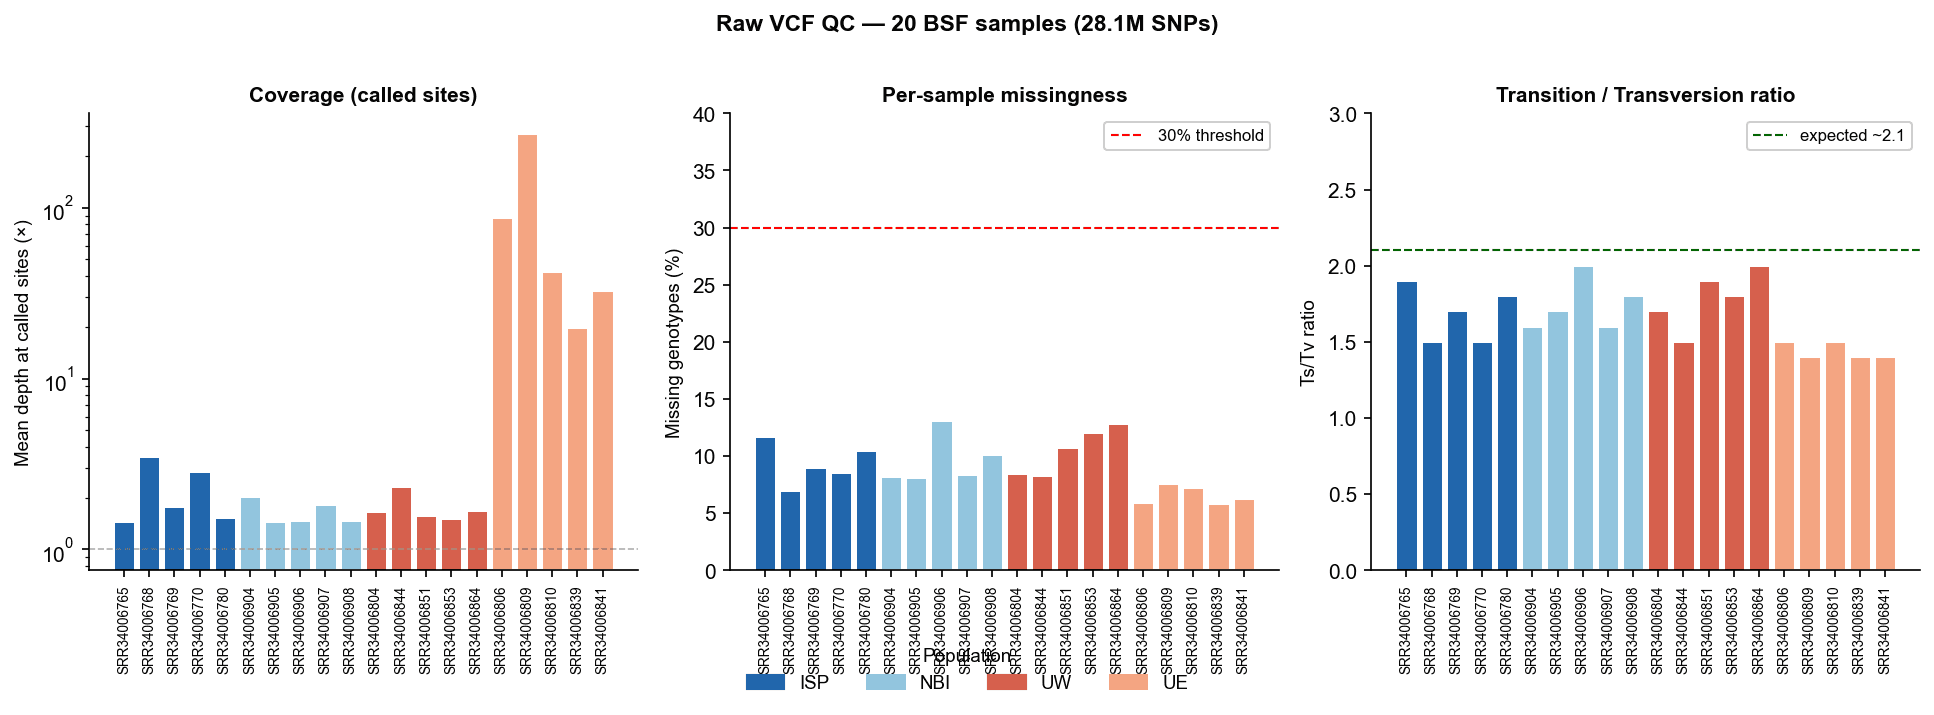
所有 20 个样本均通过了单样本缺失率质控(6-13%,均远低于 30% 的排除阈值)。
各样本的 Ts/Tv 比值在 1.4-2.0 之间。这略低于哺乳动物约 2.1 的预期值,但昆虫基因组本身的 Ts/Tv 比值就原生低于哺乳动物基因组。
5 个样本(全部 UE 样本 + 2 个 UW 样本)的比对率极低(9-26%),而 12/20 的样本比对率 >90%。UE 中极端位点深度的不均匀性(在检出位点上为 20-270×,而其他群体中约为 1-3.5×)反映了少数比对上的 reads 集中在少数可及区域中——这一特征与野外采集的幼虫样本中含有高比例的微生物/环境 DNA 一致。
基于硬呼叫的群体结构
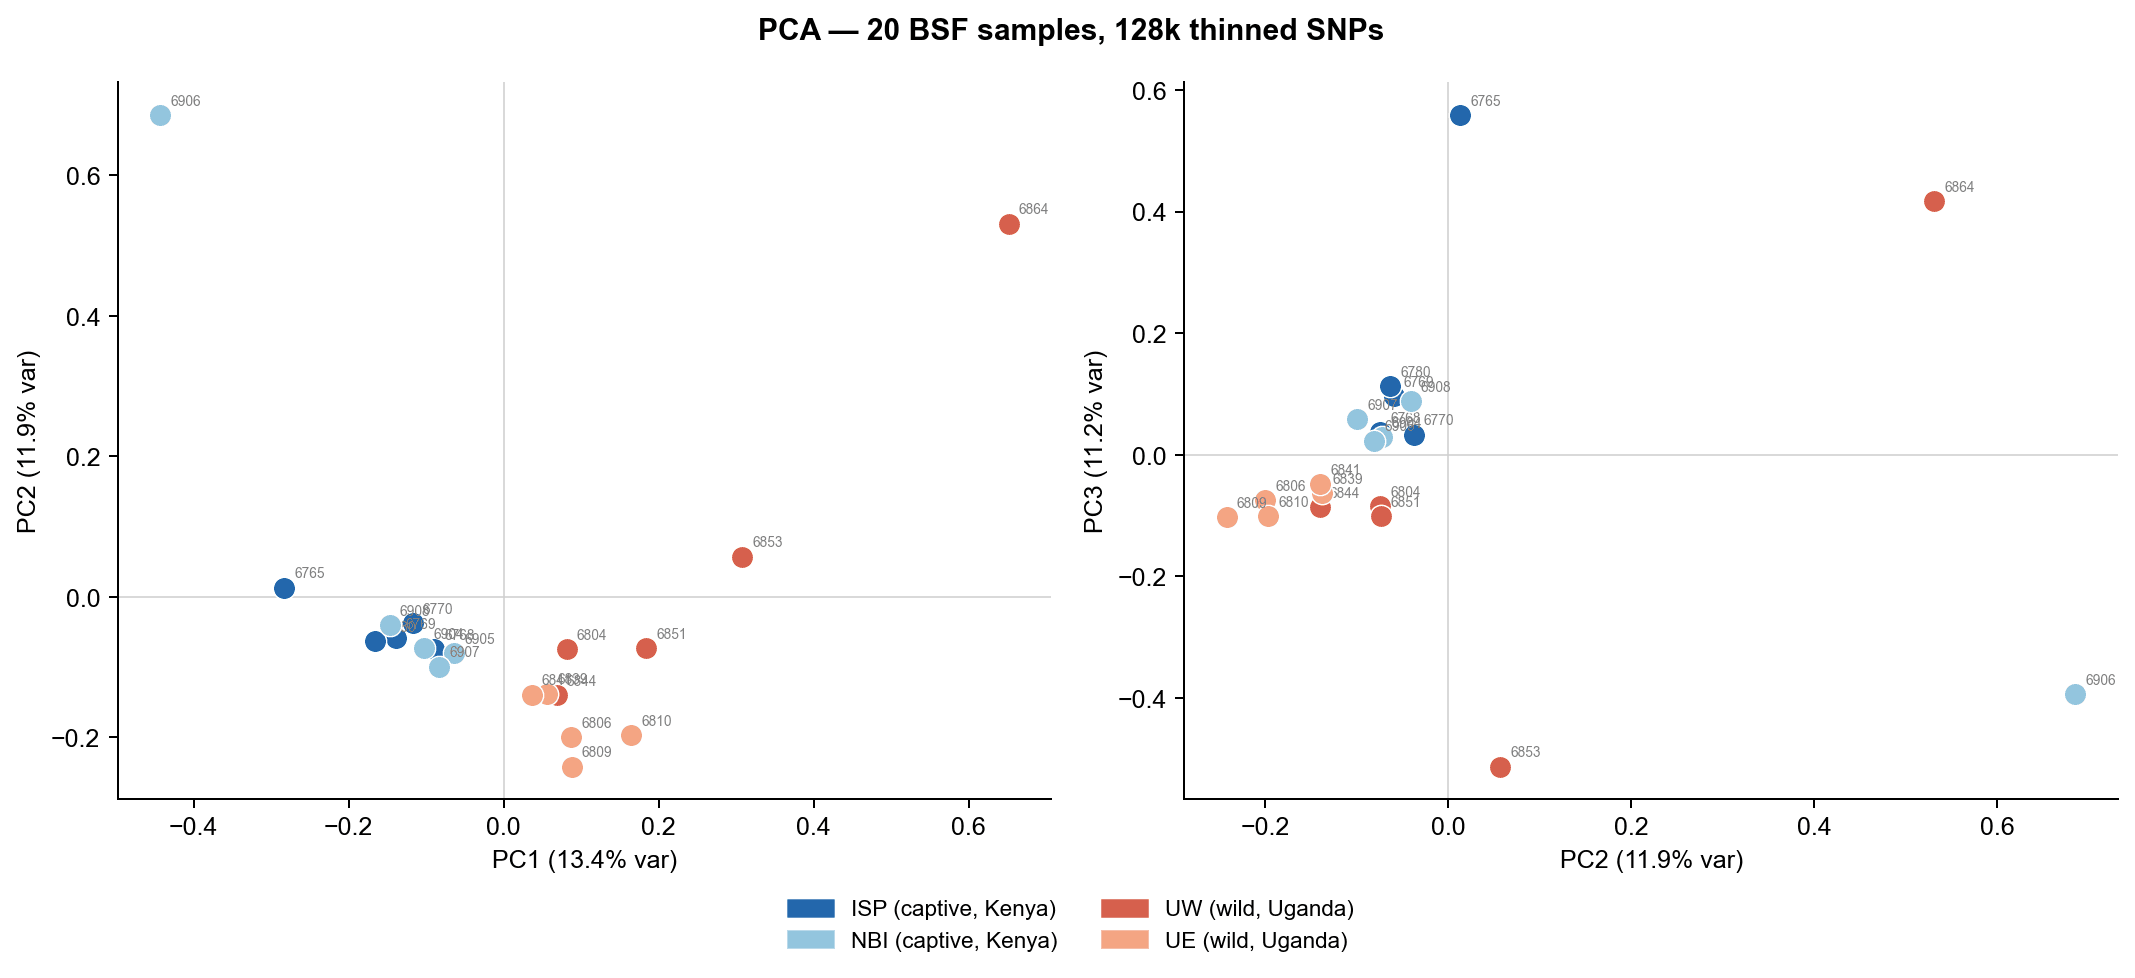
基于 128,007 个经 LD 剪切的 SNP 进行的主成分分析 (PCA) 将饲养的肯尼亚群体(ISP、NBI)与野生的乌干达群体(UW)分离开来。sNMF 混杂分析(K=2)支持了这一格局,ISP 和 UW 表现出截然不同的祖先成分,而 NBI 则表现出稍高一些的混杂多样性。

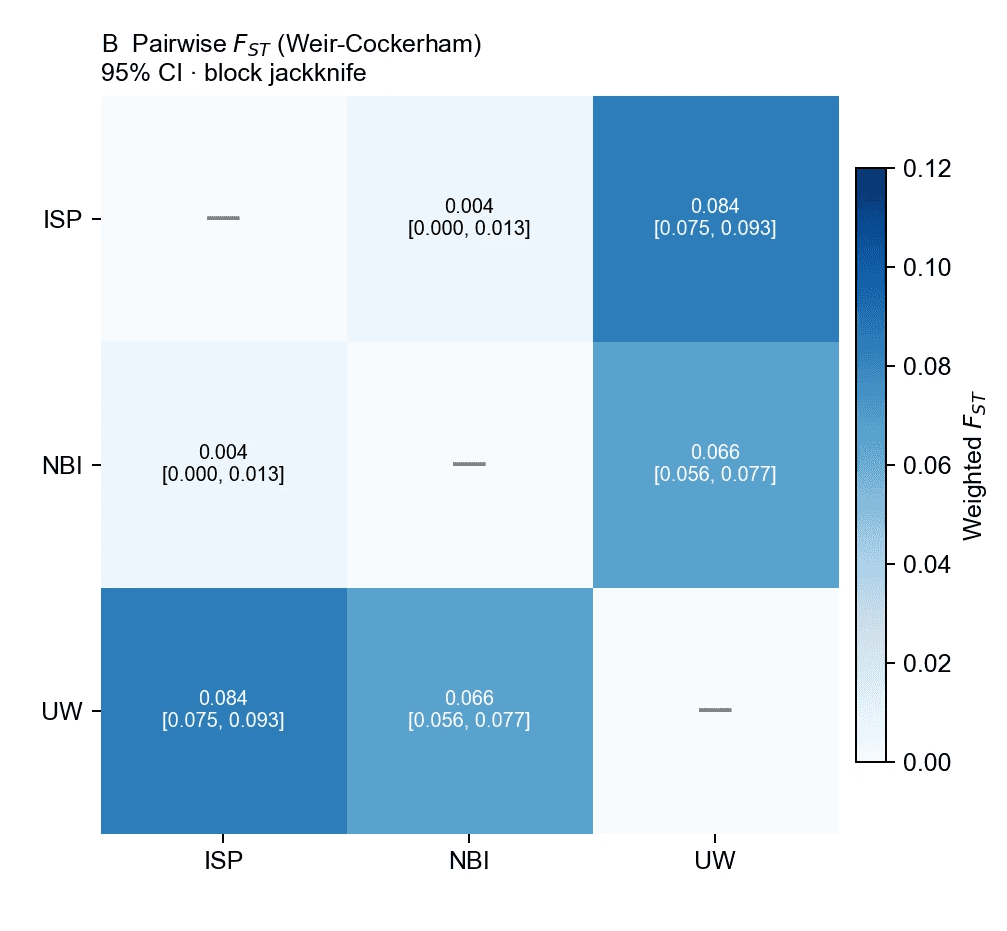
两两群体的硬呼叫 FST 估算值表明,ISP 与 NBI 之间的分化度极低(FST = 0.004),而饲养群体与野生群体之间存在中等程度的分化(ISP-UW = 0.084;NBI-UW = 0.066)。
基于基因型似然值验证的群体结构
基因型似然值 (GL) 分析证实了在硬呼叫分析中观察到的饲养-野生群体结构,同时提供了更高的分辨率。PCAngsd 识别出一个显著的 NBI 离群样本 (SRR34006906),这可能代表了基因混杂、污染或不典型的育种品系。

基于 GL 的混杂分析显示,ISP (99.3%) 和 NBI (92.4%) 具有极强的饲养群体祖先成分,而 UW 个体则主要表现出野生祖先成分。
经 GL 矫正的 FST 估算值显示出比硬呼叫方法高得多的分化度,特别是在 ISP 和 NBI 之间(0.046 对比 0.004),增幅达 11.5 倍。饲养与野生群体之间的分化度也有所提高(ISP-UW = 0.113;NBI-UW = 0.106)。
比较组合
硬呼叫 FST (PLINK2)
基于 GL 的 FST (realSFS)
变化倍数
ISP–NBI(饲养–饲养)
0.004
0.046
11.5
ISP–UW(饲养–野生)
0.084
0.113
1.3
NBI–UW(饲养–野生)
0.066
0.106
1.6
选择扫荡扫描
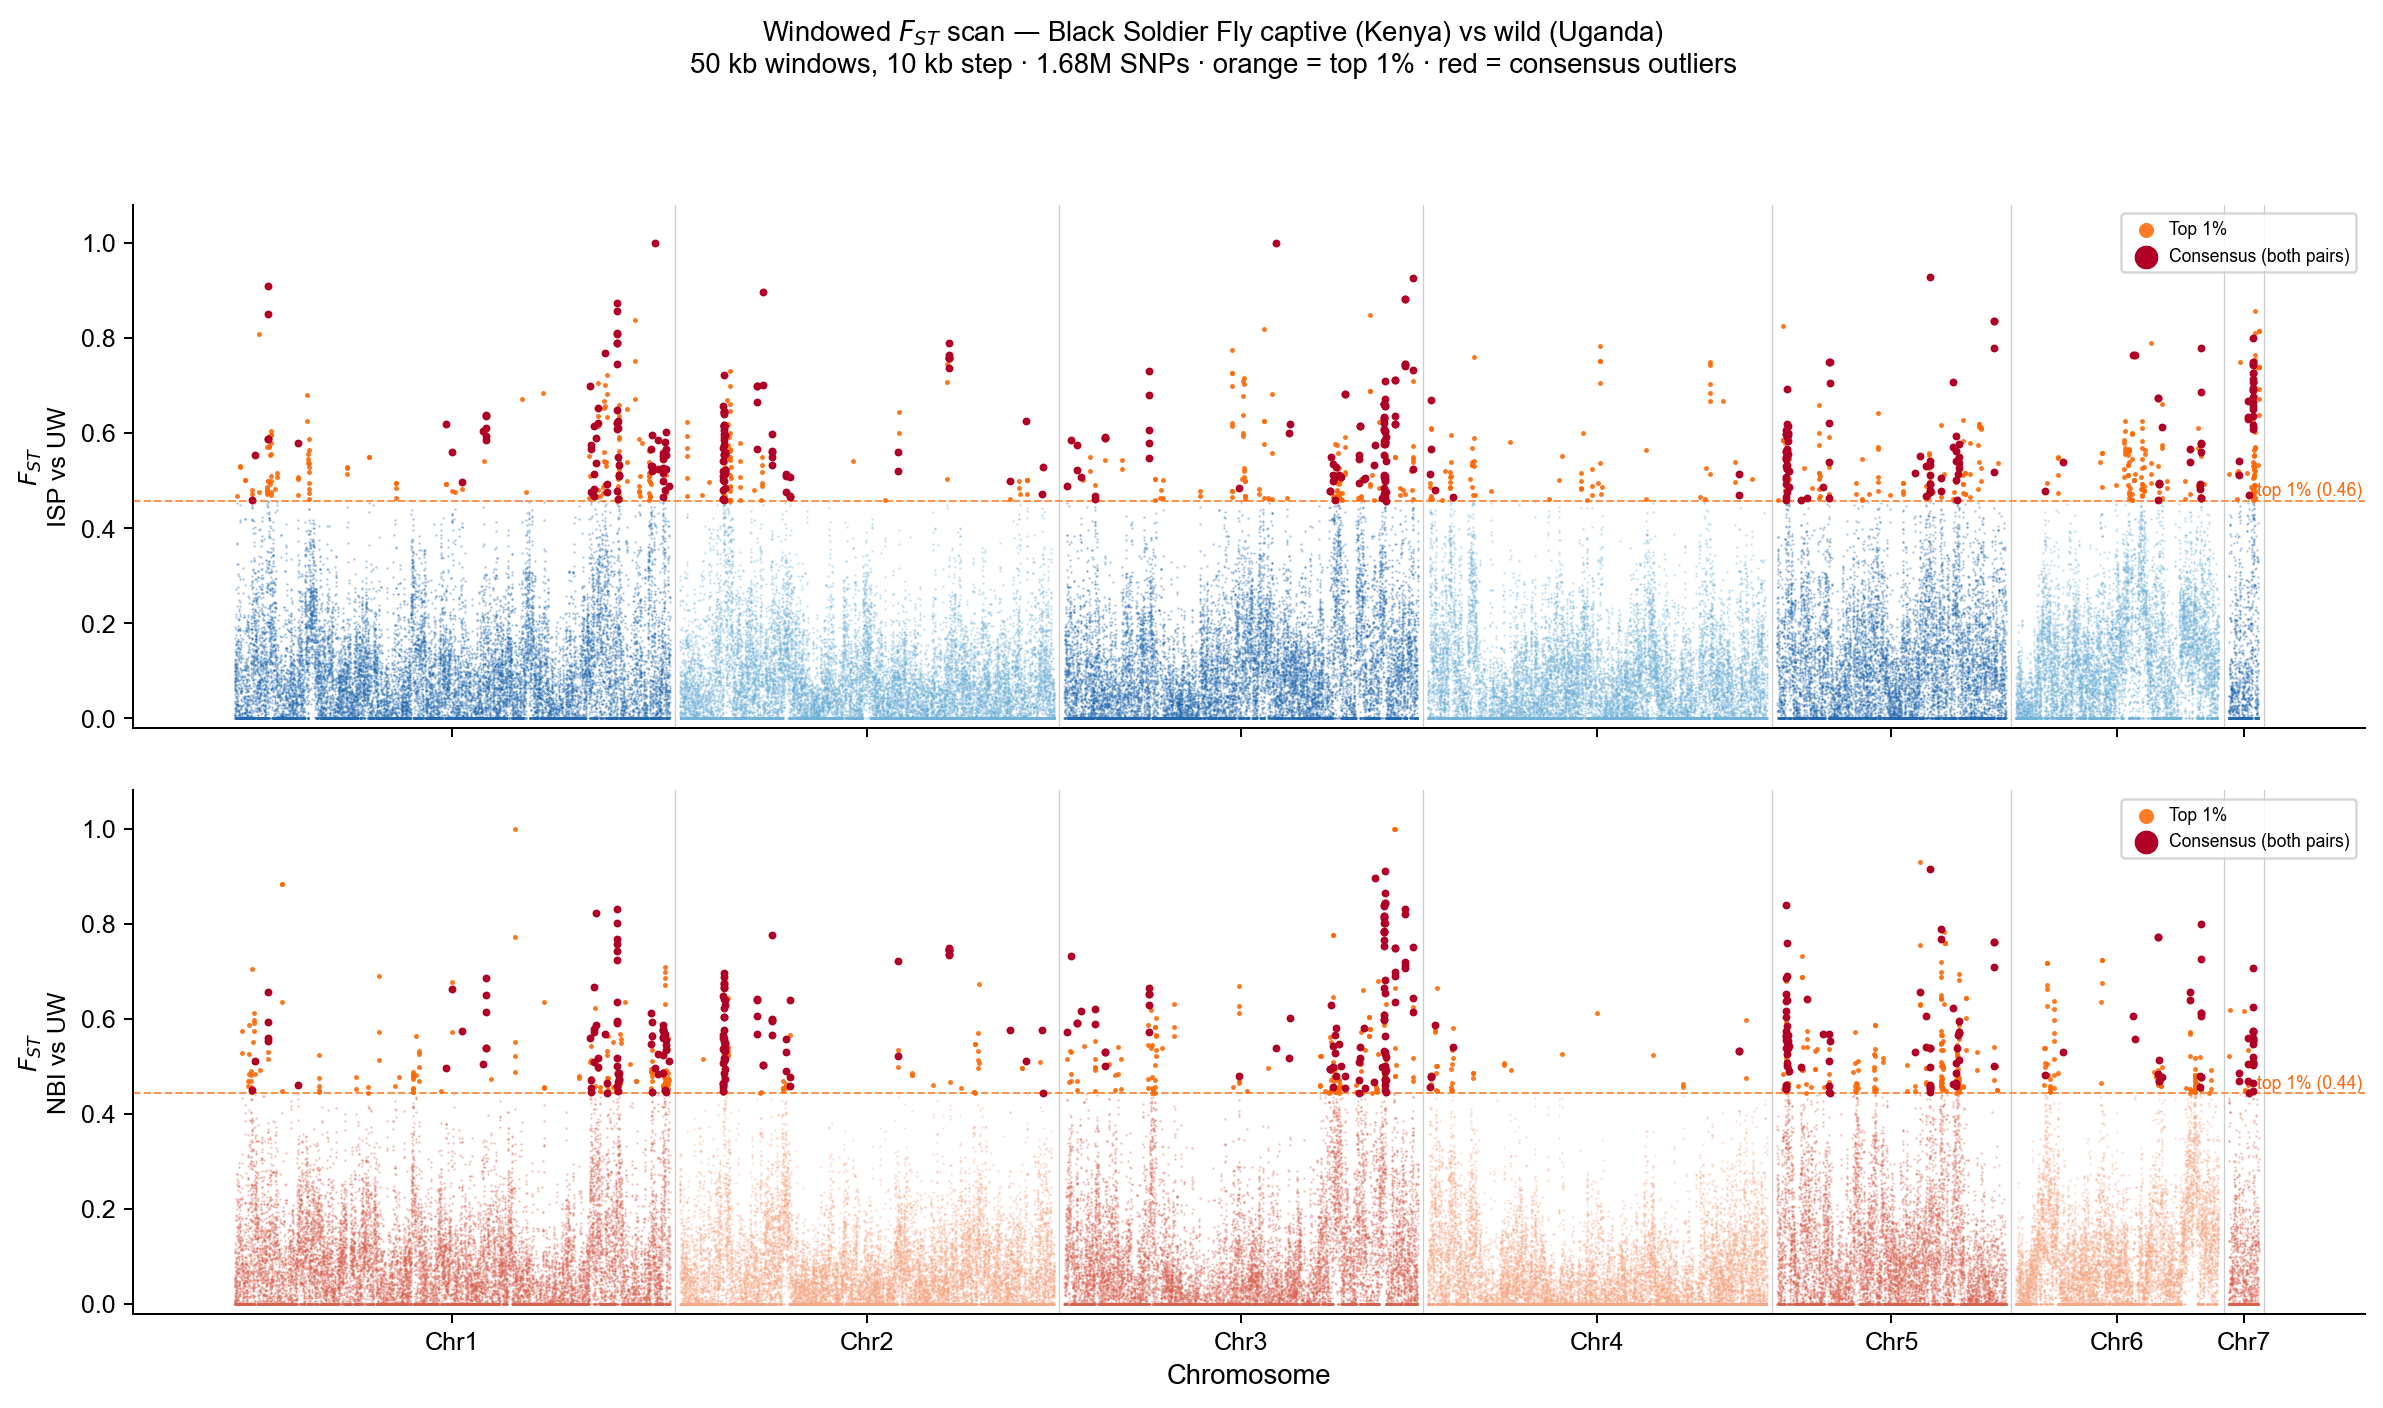
基于硬呼叫的滑窗 FST 扫描在 Chr5(约 77.9 Mb)和 Chr3(约 173.5 Mb)上发现了候选选择扫荡区域。
基于 GL 的分析显示在 Chr2(约 137.35 Mb)上有更强的信号,FST 峰值分别达到 0.801 (ISP-UW) 和 0.753 (NBI-UW)。该区域在两个饲养群体中共有,代表了驯化过程中受选择的最强候选位点。
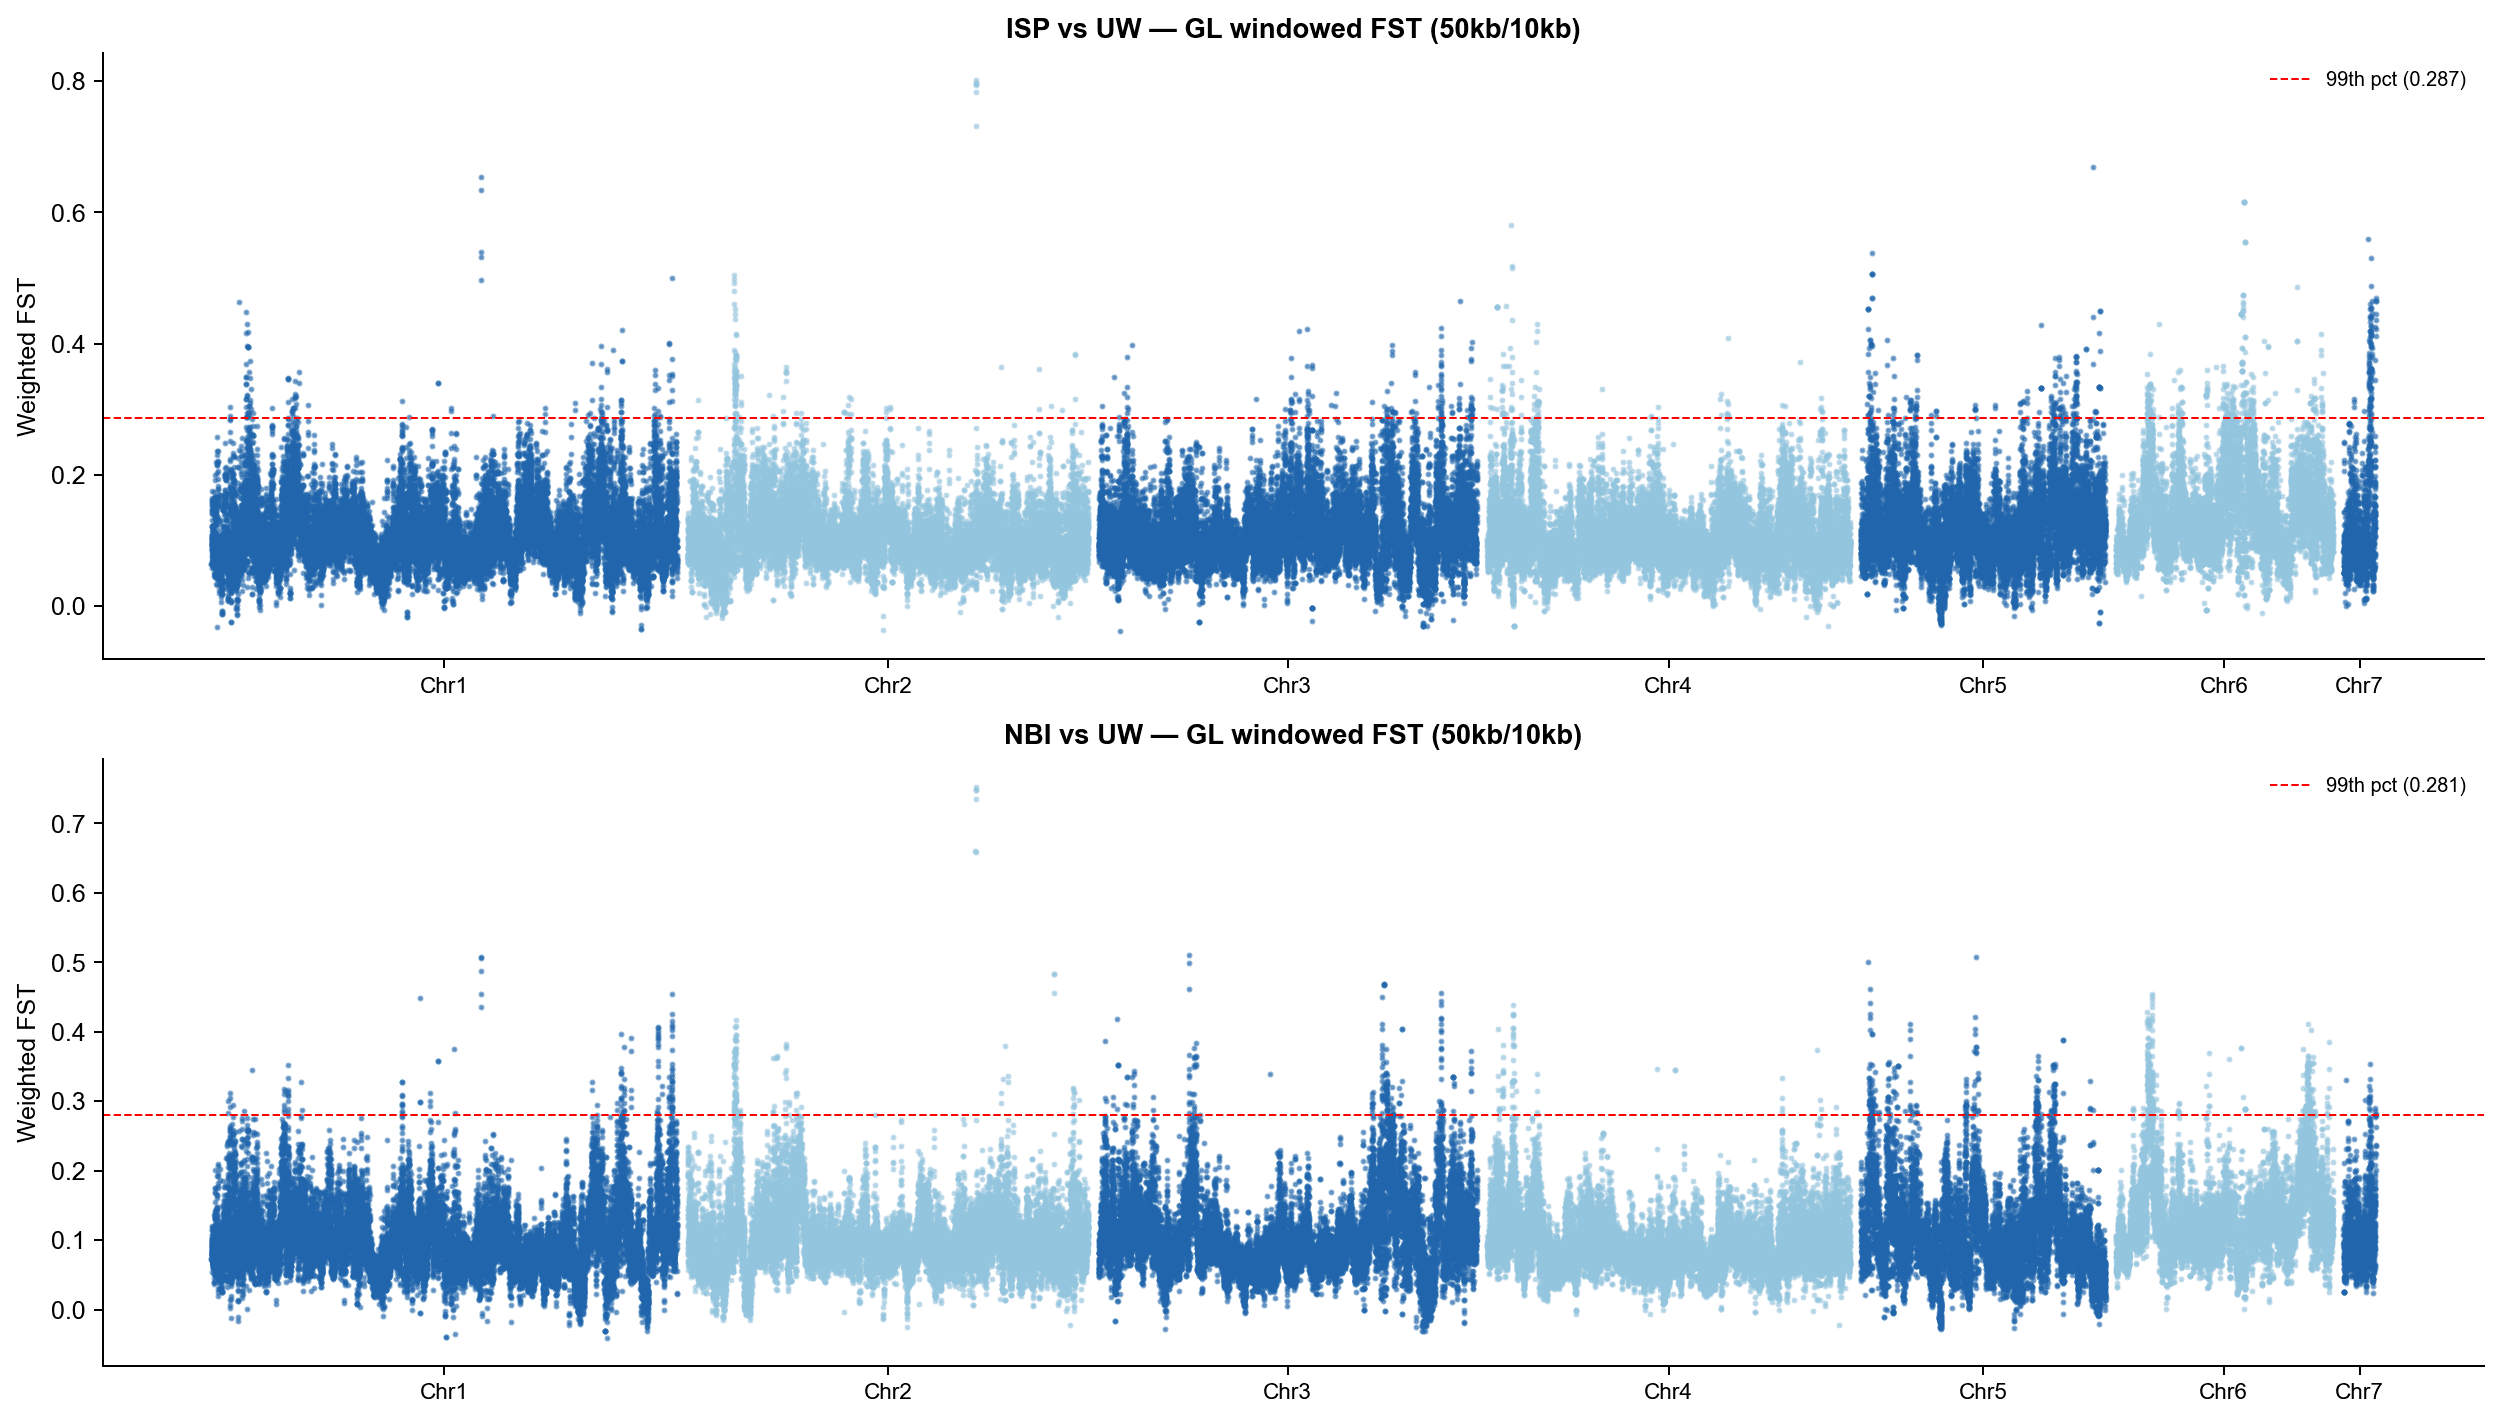
交叉验证支持 Chr5 作为次级候选区域,而 Chr3 信号降至 GL 显著性阈值以下,应视为暂定候选区域。
位点
染色体
位置
硬呼叫最大 FST
GL 最大 FST (ISP–UW)
GL 最大 FST (NBI–UW)
GL 验证通过
Peak A
Chr2 (LR899010.1)
~137.35 Mb
-
0.801
0.753
是(两者均通过)
Peak B
Chr5 (LR899013.1)
~77.9 Mb
首要候选
0.312
0.260
是(>99% 分位数)
Peak C
Chr3 (LR899011.1)
~173.5 Mb
首要候选
0.235
0.235
处于边缘